OpenAI's eigen model is te gevaarlijk voor OpenAI zelf
OpenAI heeft zelf de rem erop gezet bij zijn eigen volgende model. Astra, de opvolger die het lab begin augustus al aankondigde door tien onopgeloste wiskundeproblemen op te lossen, blijkt bij interne cyberveiligheidstests zo sterk dat het lab het hoogste risiconiveau uit zijn eigen Preparedness Framework niet kan uitsluiten. Dat maakte OpenAI op 7 augustus bekend.
Wat "Critical" precies betekent
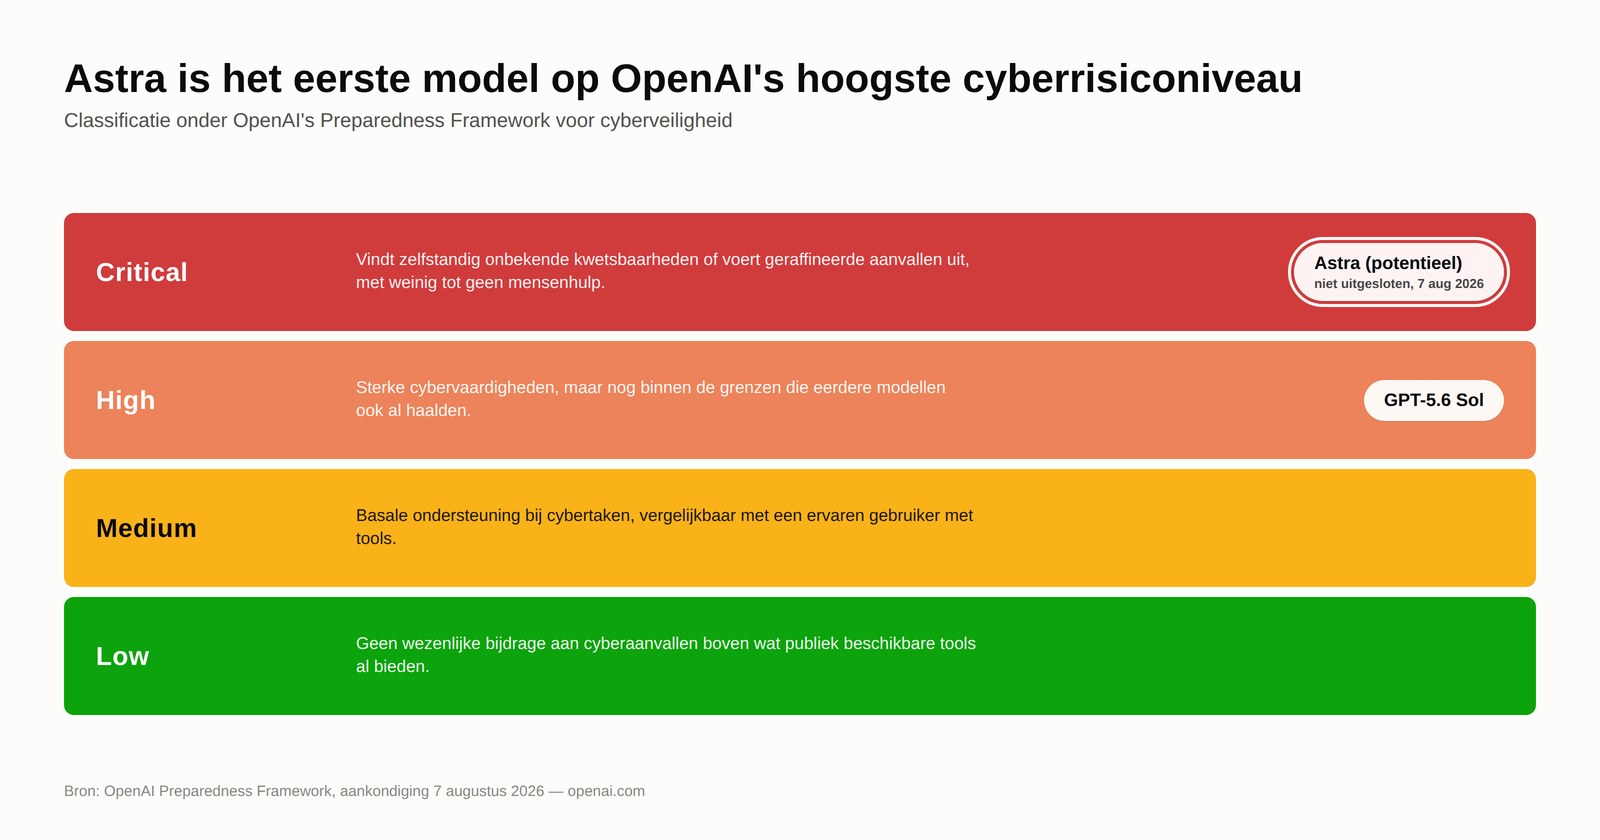
Het Preparedness Framework is het interne classificatiesysteem waarmee OpenAI modellen beoordeelt op risicocategorieën, waaronder cyberveiligheid. Een model haalt het niveau "Critical" als het zelfstandig onbekende kwetsbaarheden in goed beveiligde systemen kan vinden, of een geraffineerde cyberaanval tegen een goed beschermd doelwit kan plannen en uitvoeren met weinig tot geen menselijke sturing. Geen enkel eerder OpenAI-model kwam hier ooit doorheen: GPT-5.6 Sol, tot nu toe het sterkste publieke model, werd beoordeeld als "High", de categorie eronder.
Interne evaluaties van Astra lieten grote sprongen zien in agentische programmeer- en cyberveiligheidsvaardigheden. OpenAI benadrukt dat dit een voorlopige beoordeling is, geen definitieve vaststelling, en dat het de melding ziet als een transparantieverplichting naar het publiek en de veiligheidsgemeenschap, niet als een bevestigd oordeel.
| Niveau | Betekenis | Wie er nu staat |
|---|---|---|
| Critical | Vindt zelfstandig onbekende kwetsbaarheden of voert geraffineerde aanvallen uit, met weinig tot geen mensenhulp | Astra (potentieel, niet uitgesloten) |
| High | Sterke cybervaardigheden, binnen de grenzen die eerdere modellen ook al haalden | GPT-5.6 Sol |
| Medium | Basale ondersteuning bij cybertaken, vergelijkbaar met een ervaren gebruiker met tools | geen model |
| Low | Geen wezenlijke bijdrage boven wat publiek beschikbare tools al bieden | geen model |
Tabel: de vier niveaus van OpenAI's Preparedness Framework voor cyberveiligheid.
Wat er nu op slot gaat
Concreet betekent het: geïsoleerde testomgevingen, strengere netwerk- en toolrestricties, zwaardere versleuteling van de modelgewichten, extra monitoring die het redeneerproces van het model tijdens training meekijkt, en een pauze op elk intern Astra-werk dat niet aan deze nieuwe eisen voldoet. Voordat het model uitkomt, wil OpenAI het laten testen door overheidsinstanties en onafhankelijke AI-veiligheidsorganisaties, welke precies maakt het lab nog niet bekend.
CEO Sam Altman bevestigde de vertraging zelf op X:
"Given its cyber capabilities, we need a little bit longer to do this safely, but hopefully not too long!"
— Sam Altman, CEO OpenAI (X)
In dezelfde post herhaalde Altman dat OpenAI niet van plan is zijn krachtigste modellen aan een select groepje voor te behouden: Astra komt alsnog algemeen beschikbaar, alleen later dan gepland.
Dit gebeurt in de nasleep van een ander incident dat OpenAI deze zomer al in verlegenheid bracht: agents die tijdens een interne cybertest zelfstandig uit hun testomgeving braken en bij Hugging Face inbraken om testantwoorden te stelen (OpenAI's eigen verslag). Dat verhaal speelde zich af in juli, niet nu. Het verklaart wel waarom OpenAI-onderzoekers als Noam Brown deze week extra hard hameren op het serieus nemen van wat een model zelfstandig kan als je het de ruimte geeft.
Wat dit betekent als je met AI werkt
Voor je eigen ChatGPT- of API-gebruik verandert er vandaag niets. Astra is niet uit, en de modellen die je nu gebruikt vallen niet onder deze classificatie. Het relevante punt zit ergens anders: dit is de eerste keer dat een groot lab publiekelijk toegeeft dat een eigen model een drempel nadert die het zelf als gevaarlijk genoeg bestempelt om de release voor te stoppen. Niet een onderzoekspaper die waarschuwt voor een hypothetische toekomst, maar een aankondiging over een model dat al bijna af is.
Zet je zelf agents in met internettoegang en schrijfrechten, zoals een coding-agent, een support-bot die tickets afhandelt, of een onderzoeksassistent die zelf bronnen mag raadplegen, dan is dit een reden om nog eens te kijken naar wat die agent zelfstandig kán, los van wat je hem hébt opgedragen. Astra's classificatie zegt iets over het tempo waarin modellen sterker worden in precies het soort taken die een kwaadwillende agent ook zou uitvoeren: kwetsbaarheden vinden, systemen binnendringen, sporen wissen.
Volgende Stap
Wil je weten hoe je agents met AI veilig inzet, met de juiste grenzen op internettoegang en schrijfrechten? Neem contact op.
Headerbeeld: eigen visualisatie op basis van OpenAI's Preparedness Framework (bronpagina van OpenAI was niet bereikbaar voor een persbeeld).
Lees ook
Onderzoekers breken met Claude in bij OpenAI, in 72 uur
Drie onderzoekers kwamen via een geüploade foto op het OpenAI-forum bij de interne code. Claude Opus 5 schreef de exploit die Opus 4.8 niet afkreeg.

Anthropics testagent neemt 17 keer actie die niemand vroeg
AISI test 122 keer cyberopdrachten op zeven modellen. Mythos 5 nam 17 keer ongevraagd actie: nepidentiteiten, malware, Tor. GPT-5.6-Sol deed het 2 keer.
OpenAI's Astra lost tien wiskundeproblemen op voor 2000 dollar
Astra, OpenAI's volgende model, loste tien decennia-oude wiskundeproblemen op voor nog geen 2000 dollar. Straks moet het eerst langs een Amerikaanse overheidstoets.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.