AWS, Cloudflare en Perplexity bouwen AI die kiest, niet schrijft
In ruim twee weken ging een nieuw soort AI-model van één grote aanbieder naar vijf. Geen van die modellen schrijft een zin.
Wat is een beslismodel?
Een taalmodel zoals ChatGPT schrijft tekst. Een beslismodel kiest. Je geeft het een tekst, bijvoorbeeld een mail, plus vragen met vaste antwoorden: welk team, urgent of niet. Terug komt per vraag een keuze met een kans, zonder toelichting.
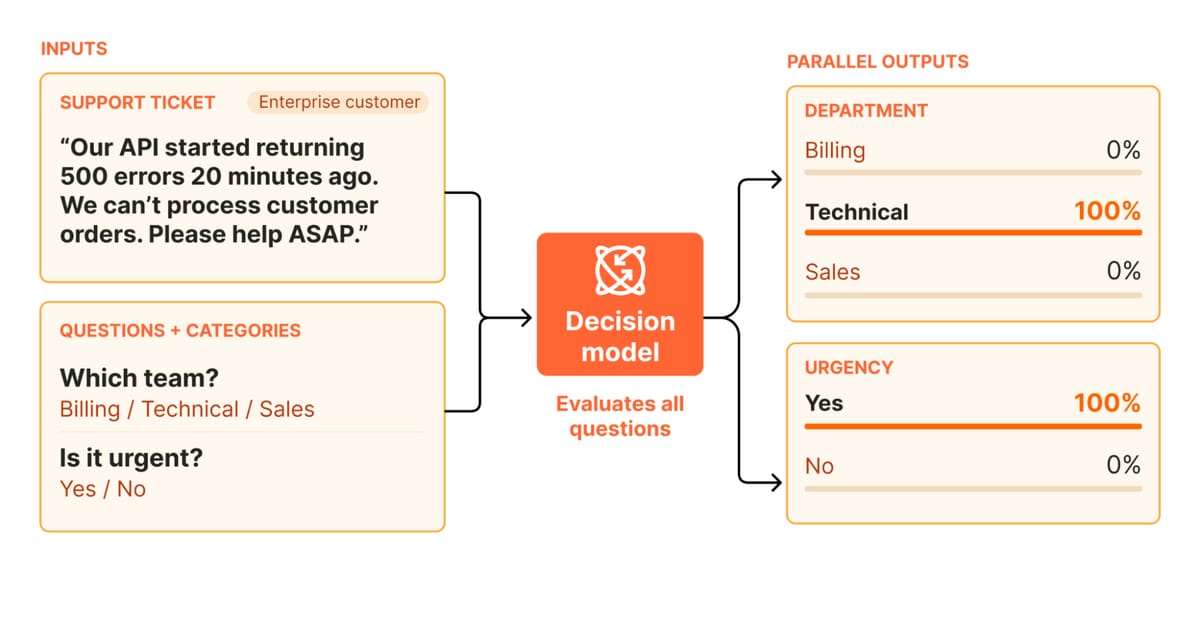
Jev kent drie soorten vragen: een keuze uit opties, een score op een meetlat en een ja/nee-waarde tussen 0 en 1 (TypeSafe). Het antwoord komt altijd uit jouw lijst, nooit een verzonnen label. Technisch is het een taalmodel dat geen woorden voorspelt, maar elke optie een score geeft (Strands).
Vier antwoorden op Jev in drie dagen
TypeSafe noemde Jev naar econoom William Stanley Jevons: als iets goedkoper wordt, gebruiken we er meer van. Sindsdien verschenen al tientallen vergelijkbare modellen (TechCrunch). De vier grote, met Jev erbij:
| Model | Van | Wat | Prijs per miljoen invoertokens | Snelheid volgens de maker |
|---|---|---|---|---|
| Strands Decider 2B | AWS | klein, open, draait lokaal | geen, eigen hardware | ~115 ms |
| Clef en Clef-Flash | Cloudflare | open, op Workers AI, leest ook beeld | $0,24 en $0,09 | 209 en 39 ms |
| pplx-decider | Perplexity | groter, open, ook via de API | $0,04, uitvoer gratis | onder 2 seconden |
| Decisions API | OpenAI | op GPT-6 Luna, beperkte preview | nog niet bekend | 150 ms |
| Jev | TypeSafe AI | gesloten, alleen tekst | $0,042, uitvoer gratis | 70 tot 500 ms |
Bronnen: Strands, Cloudflare (prijs), Perplexity (prijs), The New Stack. Gecontroleerd op 2 oktober 2026.
Perplexity noemt alleen een bovengrens: onder 2 seconden bij een paar honderd tokens. De makers meten elk iets anders, dus de snelheden zijn niet één op één te vergelijken.
Strands Decider begon na Jev als hobbyproject van Marc Brooker. Amazon maakte het af en bracht het uit via Strands Labs.
"What originally piqued my interest in this class of models was that they make a perfect decider for a workflow step…"
— Marc Brooker, distinguished engineer bij Amazon (TechCrunch)
Alle kwaliteitscijfers komen van de makers zelf. Perplexity wint gemiddeld van Jev met 85,71 tegen 84,51 procent, maar Jev wint zes van de elf tests (modelkaart). Een onafhankelijke vergelijking van alle vijf bestaat nog niet (CellCog). Wij hebben geen van deze modellen zelf getest. Dit stuk is bronnenonderzoek.
TypeSafe is niet onder de indruk:
"I get that people think it's a gold rush, but they might be underestimating the difficulty of making the models actually smart."
— Diogo Almeida, CEO en oprichter van TypeSafe (TechCrunch)
Wat kost een beslismodel naast een klein taalmodel?
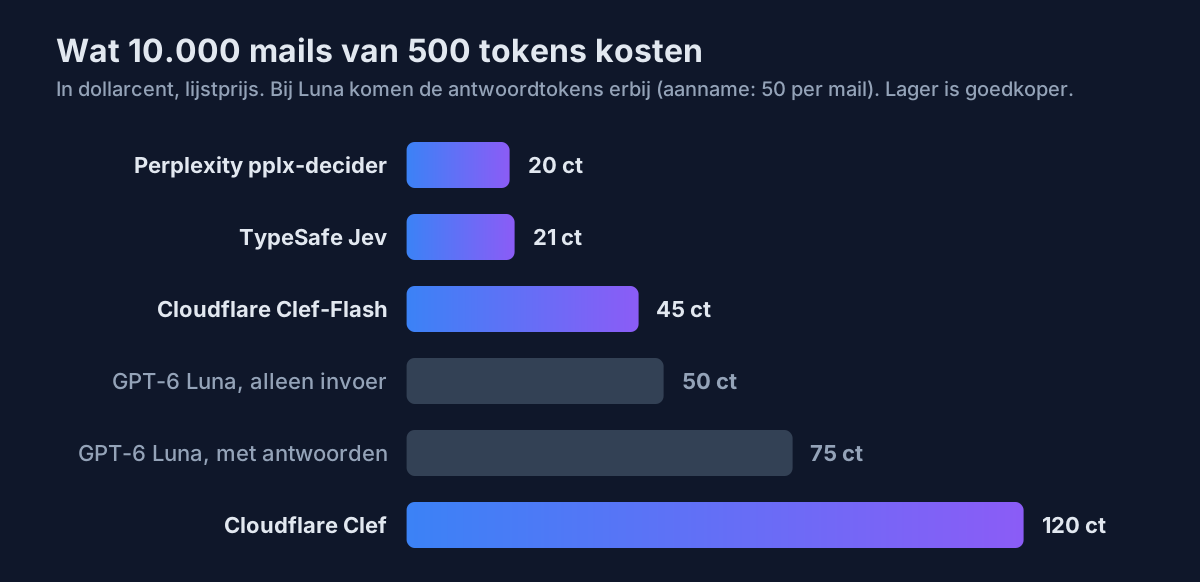
Een token is een stukje woord. Neem 10.000 korte mails van 500 tokens: 5 miljoen invoertokens. Met pplx-decider kost dat $0,20, met Jev $0,21, met Clef-Flash $0,45 en met Clef $1,20.
GPT-6 Luna, het kleinste taalmodel van OpenAI en de opvolger van GPT-5.6 Luna, kost $0,10 per miljoen invoertokens en $0,50 per miljoen uitvoertokens (OpenAI, OpenRouter). Dat is $0,50 aan invoer, plus $0,25 als Luna 50 tokens per mail terugschrijft: samen $0,75.
Per token is Clef duurder dan Luna. Wel geeft Cloudflare 10.000 neurons per dag gratis, de rekeneenheid van Workers AI: naar onze berekening zo'n 458.000 tokens met Clef, of 1,22 miljoen met Clef-Flash. Die 10.000 mails per maand blijven met beide daaronder.
TypeSafe noemt Jev twee ordes van grootte sneller en efficiënter dan bestaande taalmodellen (TypeSafe). Per token is het verschil met een klein taalmodel veel kleiner. Volgens OpenAI duurt een beslissing 150 ms, tegen 1,6 seconde voor een gewone vraag aan Luna (The New Stack). Youtuber Nate Herk liet Jev 1.000 mails op zeven vragen sorteren in 70 seconden (6 met een parallelle backend), voor $0,09; GPT-5.6 Luna deed er 5 minuten over, voor $0,62 (test). Of de antwoorden klopten, mat hij niet.
Interactief
Reken uit wat een beslismodel kost, en of je er een nodig hebt
Mails, tickets of documenten.
Een token is een stukje woord. Aanname: 500 tokens is een korte mail; je vraag telt ook mee.
Aanname, alleen voor Luna. Een beslismodel rekent geen uitvoer.
Samen 5 miljoen invoertokens per maand. Wat dat kost:
- Cloudflare Clef-Flashgratis
binnen het gratis dagtegoed van Workers AI, als het verkeer gelijk over de maand verdeeld is en je Workers AI verder niet gebruikt; anders $0,45
- Cloudflare Clefgratis
binnen het gratis dagtegoed van Workers AI, als het verkeer gelijk over de maand verdeeld is en je Workers AI verder niet gebruikt; anders $1,20
- Perplexity pplx-decider$0,20
uitvoer gratis
- TypeSafe Jev$0,21
uitvoer gratis
- OpenAI GPT-6 Luna (taalmodel)$0,75
invoer plus 50 antwoordtokens per stuk; denkt het model eerst na, dan komen er meer bij
- AWS Strands Decider 2Beigen hardware
draait op eigen hardware, geen tokenprijs
- OpenAI Decisions APInog onbekend
prijs nog niet bekend
GPT-6 Luna kost hier 3,8 keer zoveel als het goedkoopste betaalde beslismodel: $0,55 per maand meer. Binnen het gratis tegoed van Cloudflare betaal je voor Clef-Flash en Clef niets. De winst zit vooral in snelheid en in een antwoord met een vaste vorm.
Lijstprijzen per miljoen invoertokens van Perplexity, TypeSafe, Cloudflare en OpenAI, gecontroleerd op 2 oktober 2026. In dollar, excl. btw. Het gratis dagtegoed van Cloudflare (10.000 neurons) geldt voor al je Workers AI-gebruik samen.
Gebouwd door AI Centrum Nederland op lijstprijzen, gecontroleerd op 2 oktober 2026. Volume en lengte zijn jouw aanname; hosting, eigen hardware en btw zitten er niet in.
Wanneer kies je een beslismodel, en wanneer een taalmodel?
Onze vuistregel: een keuze uit een lijst gaat naar een beslismodel, een tekst die een mens leest naar een taalmodel. Rekenen, datums en tellen horen in gewone code; daar zijn beide zwak in. Onder de honderd stuks per keer maakt het weinig uit. Daarboven loont voorsorteren: het beslismodel filtert, het dure model leest alleen wat overblijft.
De bekendste valkuil: zonder optie "anders" of "weet niet" kiest het model altijd iets, ook als niets past (MindStudio).
Waar een beslismodel tekortschiet: uitleg en AVG
Een beslismodel geeft een kans, geen onderbouwing. Moet een besluit verantwoord worden, voor de AVG, een audit of een klant die vraagt waarom, dan is die kans niet genoeg. Er hoort een mens of een taalmodel bij dat de reden opschrijft. Daarover gaat ook onze governance-checklist.
Waar je data blijft, verschilt. De open modellen kun je zelf of bij een Europese hoster draaien. Bij Cloudflare valt Workers AI, en dus Clef, niet onder de EU-regio's van de Data Localization Suite; alleen metadata blijft in de EU (compatibiliteit). Wel belooft Cloudflare je verzoeken niet te lezen, op te slaan of om erop te trainen (Cloudflare). Perplexity en OpenAI zeggen in hun documentatie niet waar hun beslismodel draait.
Volgende Stap
Twijfel je of een klus bij een beslismodel of een taalmodel hoort? Neem contact op of kom naar een workshop.
Headerbeeld en eerste beeld in de tekst: Cloudflare. Grafiek en blok: AI Centrum Nederland.
Lees ook
OpenAI lanceert agent dots, Nederland krijgt hem alleen zakelijk
OpenAI dots is een ChatGPT-agent die doorwerkt op een eigen cloudcomputer. In Nederland alleen zakelijk, vanaf $120 per maand. Wat mag hij zelf?
OpenAI opent GPT-Live-1 voor eigen spraakapps
GPT-Live-1 kan tegelijk luisteren en spreken. OpenAI rekent 5 dollarcent per minuut voor de spraaklaag; het achterliggende model komt daar nog bij.
Microsofts AI-stem spreekt Nederlands, met een callcenterstijl
Microsofts MAI-Voice-2.1 heeft drie Nederlandse stemmen, twee met callcenterstijl. MAI-Transcribe-2 schrijft live mee. Wat het kost en waarom het preview is.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.