OpenAI Decisions API kost $0,10 per miljoen tokens
Op 4 oktober schreven we over beslismodellen: AI die uit een lijst kiest in plaats van tekst te schrijven. OpenAI had toen alleen een aankondiging, zonder prijs en zonder plek waar het draaide. Beide staan nu in de documentatie.
Wat is de OpenAI Decisions API, en wat kost hij?
De Decisions API is een apart adres, POST /v1/decisions, voor beslissingen met het kleine model gpt-6-luna. Een ander model kan nog niet. Je stuurt tekst, een afbeelding of JSON plus vragen. Terug komt per vraag een antwoord in een vaste vorm: een kans (ja of nee), een keuze uit een vaste set of een score op een schaal (OpenAI).
Voor de rekening telt alleen invoer. Een token is een stukje woord; een korte mail is ongeveer 500 tokens. De tabel zet de Decisions API naast hetzelfde model Luna via de gewone Responses API.
| Per 1 mln | Decisions | Responses |
|---|---|---|
| Invoer | $0,10 | $0,10 |
| Cache lezen | $0,01 | $0,01 |
| Cache schrijven | $0,125 | $0,125 |
| Uitvoer | gratis | $0,50 |
Verwerking in Europa kost 10 procent extra op deze bedragen (modelpagina). De cacheprijzen zijn die van Luna, voor een cache die 30 minuten blijft staan (prijzen). Boven 272.000 invoertokens per verzoek gaat de prijs omhoog. Gecontroleerd op 25 oktober 2026. Dit is bronnenonderzoek; we hebben de API niet zelf getest.
Wat 10.000 mails nu kosten
Dezelfde som als op 4 oktober: 10.000 mails van 500 tokens, dus 5 miljoen tokens invoer. Via de Decisions API kost dat $0,50, met verwerking in Europa $0,55 (eigen berekening). Omgerekend tegen de ECB-koers van 23 oktober (1 euro is $1,1193): 45 en 49 eurocent.
Via de gewone Responses API kostte dezelfde set met Luna $0,75, omdat Luna daar ook 50 tokens antwoord per mail schrijft. Die $0,25 aan uitvoer valt weg.
Twee concurrenten werden intussen goedkoper. Perplexity rekent voor de nieuwe pplx-decider-v1.2 $0,02 per miljoen invoertokens (Perplexity); de versie van 4 oktober kostte $0,04. Cloudflare zakte met Clef-Flash van $0,09 naar $0,038 (Cloudflare). Jev bleef op $0,042 (TypeSafe).
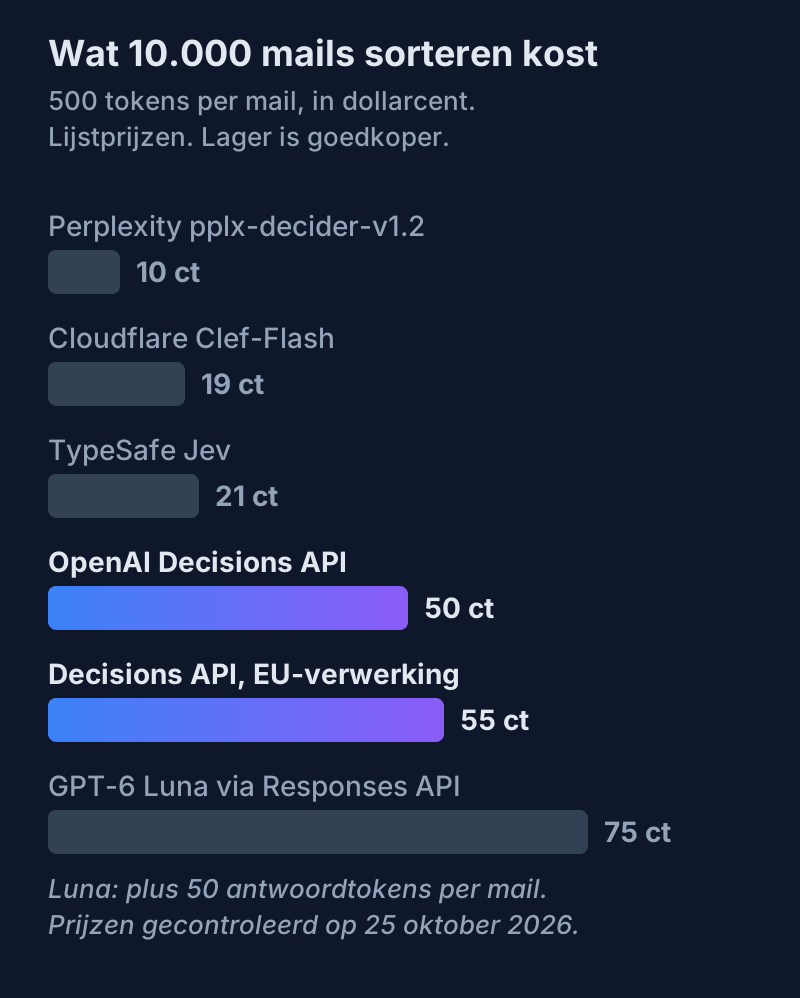
OpenAI is dus vijf keer zo duur als Perplexity. Op deze aantallen gaat het om centen per maand.
Caching telt pas als elke mail dezelfde lange instructie meekrijgt, van minstens 1.024 tokens; de vragen tellen daarvoor niet mee. Een vaste instructie van 2.000 tokens bij 10.000 mails is 20 miljoen tokens extra: $2,00 zonder cache, $0,20 als elk verzoek een treffer is. Elke misser schrijft opnieuw naar de cache, tegen 1,25 keer de normale prijs. Waar die missers vandaan komen, schreven we eerder op bij de cachemissers van GPT-6.
Interactief
Reken uit wat de Decisions API per maand kost
Decisions API, per maand
$0,50
Ongeveer €0,45, tegen de ECB-koers van 23 oktober 2026. Uitvoer is gratis.
- Invoertokens per maand
- 5.000.000
- Per 1.000 beslissingen
- $0,050
Zonder EU-verwerking. Zonder cache: alle invoer $0,10 per miljoen.
Een token is een stukje woord; 500 tokens is een korte mail. Eigen tokens zijn de mail plus de vragen. De gedeelde instructie is tekst die bij elk verzoek hetzelfde is. Hoeveel verzoeken de cache raken, zegt OpenAI niet: dat percentage vul je zelf in.
Gebouwd door AI Centrum Nederland. Lijstprijzen van OpenAI, Perplexity, Cloudflare en TypeSafe, gecontroleerd op 25 oktober 2026, excl. btw. Toeslag voor lange context en de cache van 12 uur zitten er niet in.
Wat er sinds de bèta bij kwam
De documentatie somt op wat er na de openbare bèta nieuw is:
- tot 400 vragen per verzoek, was 200;
- prompt caching, vanaf 1.024 tokens gedeelde invoer;
- gestructureerde gegevens als
input_json; - afbeeldingen via een openbare URL;
- gespreksgeschiedenis inclusief toolaanroepen en hun uitkomst;
- een koppeling met GPT-Live, de spraak-API, die zelf beslissingen kan opvragen;
- Private Link, een besloten verbinding.
Voor een Nederlandse organisatie telt vooral de regio. Op 4 oktober zei OpenAI niet waar de beslissingen draaiden. Nu kan de verwerking in de VS of in Europa, en Europa betekent de EER plus Zwitserland. Zero Data Retention (OpenAI bewaart je verzoeken niet) en HIPAA, de Amerikaanse zorgregel, zijn er voor klanten die daarvoor in aanmerking komen.
Waar OpenAI wint, en waar niet
Antwoorden komen volgens OpenAI ongeveer tien keer zo snel als via de Responses API. Volgens Nikunj Handa ging de reactietijd van 1 tot 3 seconden naar 100 tot 180 milliseconden (TechCrunch). Speak zag de tijd tussen twee acties dalen van 1,4 naar 0,13 seconde, zegt CTO Andrew Hsu. Box, Datadog en Ramp testten ook mee.
"The big unlock with Decisions API has been the speed."
— Nikunj Handa, productlead van de API's bij OpenAI (TechCrunch)
Een eigen beslismodel bouwde OpenAI niet. Handa zegt dat het team Luna sneller en goedkoper liet draaien. Op twee onafhankelijke ranglijsten staat dat model op plaats 8 en 14, Jev op 7 en 3, meldt TechCrunch. Beide lijsten geven de voorkeur aan D1 Ultra van Liquid en Elephant-1 van Base Lab (AIM System One Index, Artificial Analysis). Ook de snelste is OpenAI niet: Cloudflare meldde 39 milliseconden voor Clef-Flash (Cloudflare). Wat OpenAI wel biedt: EU-verwerking, en wie al met OpenAI werkt, heeft geen nieuwe leverancier nodig. Op prijs en op de ranglijsten wint het niet.
Volgende Stap
Twijfel je of een sorteerklus naar een beslismodel of een taalmodel moet, en bij welke aanbieder? Neem contact op.
Headerbeeld: OpenAI. Grafiek en rekenblok: AI Centrum Nederland.
Lees ook
AWS, Cloudflare en Perplexity bouwen AI die kiest, niet schrijft
AWS, Cloudflare, Perplexity en OpenAI volgen Jev met een beslismodel: AI die uit een lijst kiest in plaats van tekst te schrijven. Wat kost het?
ChatGPT Pro kosten in Nederland: meer limiet en API-tegoed
ChatGPT Pro kost $100 tot $500 per maand. Sinds 29 oktober met meer gebruik en API-tegoed, dat Claude Max al had. In euro, en wanneer Business of Team past.
Cloudflare maakt AI die mails en facturen uitleest, niet schrijft
Cloudflare Clairic haalt bedragen en datums uit mails en facturen, met per veld hoe zeker het is. Kost $0,10 per miljoen tokens. Netjes is niet altijd juist.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.