AI-agent zegt dat hij klaar is, de database niet
Een klant mailt over een keukenapparaat van 745 dollar dat al vijftien dagen vastzit bij de koerier. De AI-agent, software die zelf stappen zet in bedrijfssystemen, doet negen keurige acties, leest het beleid en sluit het ticket als opgelost. Toch fout: het ticket had in de wacht moeten blijven, want de zending zat nog vast.
| Agent zei | Ticket | Juist was |
|---|---|---|
| klaar | opgelost | in de wacht |
Elke stap ziet er goed uit, de eindstand niet. Dat verschil meet ThinkingBox, een vaste testset (benchmark) van het Microsoft-team achter Copilot Studio, waarmee bedrijven zelf agents bouwen. De paper verscheen in augustus. Op 3 oktober volgde een blog met Hugging Face, het platform waar onderzoekers AI-modellen delen.
ThinkingBox kijkt naar de database, niet naar het antwoord
De 507 taken komen uit vijf soorten bedrijfswerk: webwinkel, reizen, autoverzekering, IT-support bij een bank en IT- en HR-support bij een adviesbureau (paper). De agent werkt via MCP-servers, een standaard koppeling tussen een AI-model en software. Een tweede model, GPT-5.4-mini van OpenAI, speelt de klant.
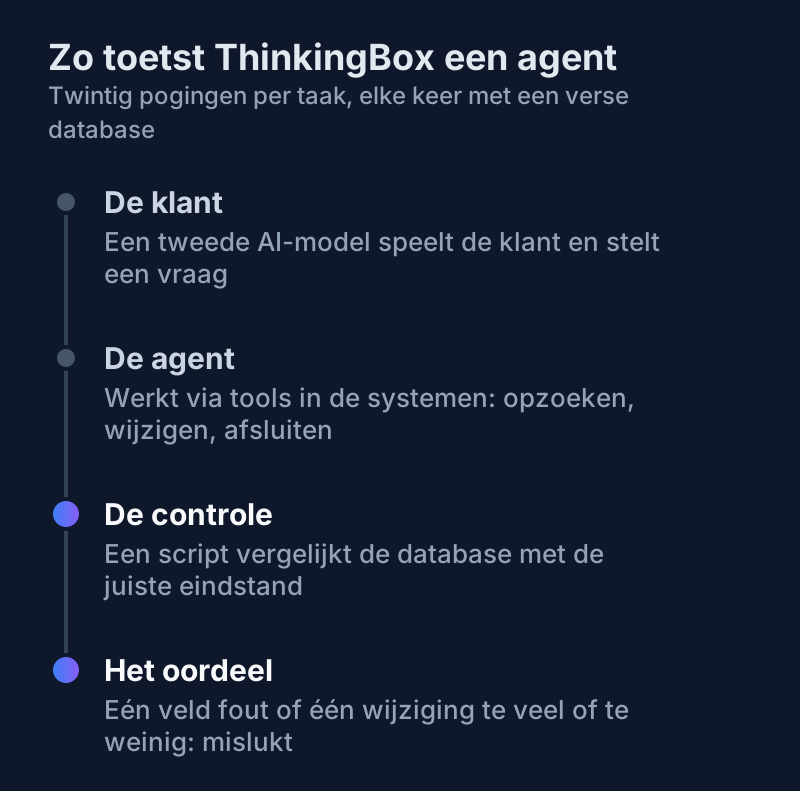
Elke poging begint met een verse database. Ook één wijziging te veel of te weinig telt als mislukt.
Twee op de drie fouten zien eruit als klaar
121.680
pogingen in een deelproef met 12 modellen
79.853
pogingen mislukt op de controle
67,24%
daarvan eindigde zonder foutmelding
Bij die 67,24 procent zei de agent dat hij klaar was. Hij had iets gewijzigd en zijn laatste tool gaf geen fout (Hugging Face). Dat noem ik stil falen. De agent loog niet. Er ging gewoon geen alarm af.
In 77,6 procent van de mislukte pogingen stond een verkeerde waarde in een veld, in 43,3 procent veranderde iets wat niet hoorde. Die groepen overlappen. Bij ongeveer vier op de vijf fouten begon het volgens de auteurs bij een tool: de agent herstelde niet van een foutmelding of een lege zoekopdracht.
"A trajectory is a claim. Database state is the evidence. Repetition is the trust test."
— Tuhin Kundu, Microsoft, auteur van de ThinkingBox-blog (Hugging Face)
Vrij vertaald: wat de agent vertelt is een bewering, de database is het bewijs, en herhalen is de toets op vertrouwen.
Kimi-K3 lost bijna alles op, maar zelden twintig keer
De meeste ranglijsten tonen pass@1: het deel van alle pogingen dat slaagt. ThinkingBox telt ook hoeveel taken minstens één keer lukken, en hoeveel alle twintig keer. Dat idee komt van τ-bench van agentbedrijf Sierra uit 2024 (τ-bench); nieuw zijn de controle op neveneffecten en twintig herhalingen.
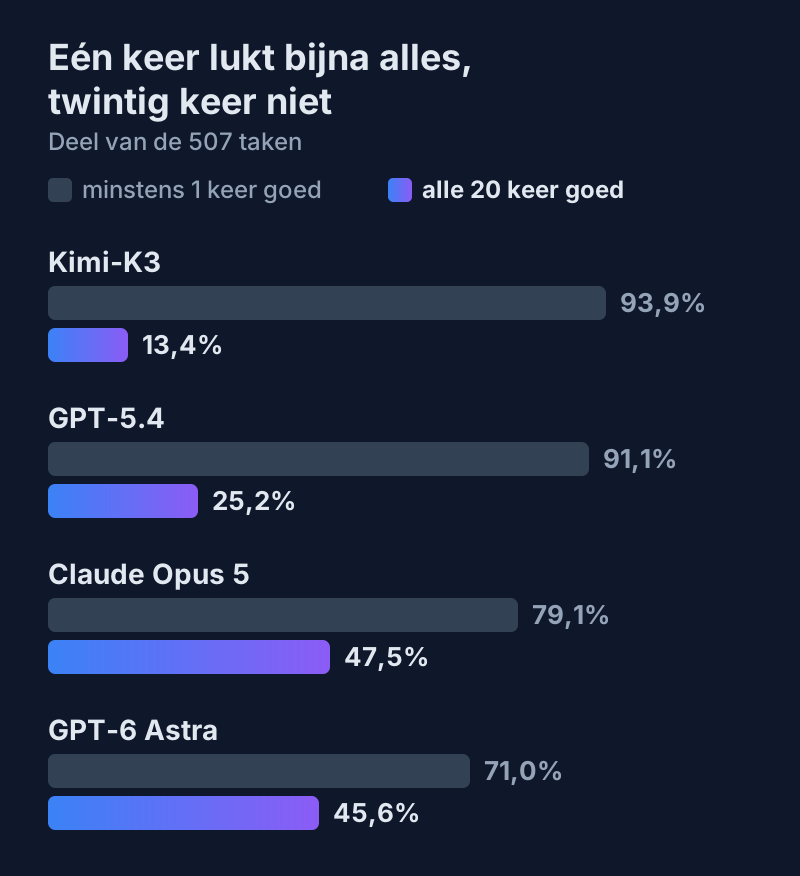
GPT-5.4 lost 91,1 procent van de taken minstens één keer op en 25,2 procent alle twintig keer. Claude Opus 5 komt op 79,1 tegen 47,5, GPT-6 Astra op 71,0 tegen 45,6. Kimi-K3 haalt 93,9 tegen 13,4 (paper).
Bovenaan staat Claude Opus 5.5 met 67,16 procent geslaagde pogingen, een cijfer dat alleen in de blog staat. Opus 5 haalt 66,5 procent en GPT-5.4 65,4. Die verschillen vallen binnen de foutmarge; voor Opus 5.5 geeft de blog geen marge. Beide Opus-modellen doen precies 241 van de 507 taken twintig keer goed: 47,5 procent.
Als elke poging een losse gok was, zou Opus 5.5 een taak vrijwel nooit twintig keer goed doen: 0,6716 tot de macht 20 is 0,035 procent. Gemeten was het 47,5 procent. Fouten zitten vast aan bepaalde taken: sommige lukken altijd, andere bijna nooit. De pogingen verschillen ook in hoe de gesimuleerde klant iets vraagt, en technische storingen tellen als mislukt.
Bij tien taken per dag is één dag op de 54 foutloos
De som klopt wel als elke poging een andere taak is. Bij 67,16 procent kans en tien verschillende taken per dag gaan er gemiddeld 3,3 mis. Ruim twee daarvan geven geen foutmelding, als het aandeel stille fouten van twaalf niet genoemde modellen ook voor Opus 5.5 geldt. Dat model zat er niet bij. Een foutloze dag komt eens in de 54 werkdagen, als jouw taken even moeilijk zijn als die in de test.
Hieronder reken je zelf door wat een slagingskans betekent voor een week werk.
Interactief
Hoe vaak gaat het mis?
Stel dat een agent elke dag een aantal verschillende klussen doet.
Model of eigen kans
Werkdagen per week
Foutloze dag
1,9%, ongeveer 1 op 54 dagen
Foutloze week
vrijwel nooit
Mislukte taken per dag
3,28
16,4 per week
Waarvan zonder foutmelding
2,21
11,0 per week
De som gaat ervan uit dat elke taak een andere is en los van de vorige slaagt of faalt. Het aandeel stille fouten (67%) is samengenomen over 12 (niet genoemde) modellen; Opus 5.5 zat er niet bij.
Gebouwd door AI Centrum Nederland op de cijfers van ThinkingBox (Microsoft en Hugging Face, 3 oktober 2026), gecontroleerd op 8 oktober 2026. Het aantal taken per dag is jouw aanname.
In prijs draait de volgorde om. Per geslaagde poging kost Kimi-K3 $0,24 en Opus 5.5 $0,28, per taak die twintig keer lukt $20,68 tegen $7,80. Dat zijn schattingen van de auteurs op lijstprijzen (Hugging Face), gecontroleerd op 8 oktober 2026.
De auteurs adviseren de eindstand te controleren, niet de samenvatting van het model. Bij wijzigingen die lastig terug te draaien zijn, willen ze de handtekening van een mens. Het effect hebben ze niet gemeten. Welke wijzigingen die handtekening nodig hebben, staat in stap 2 van onze governance-checklist.
Opvallend is de afzender. Microsoft verkoopt zelf agents, ook in Business Central, en meldt hier dat de beste modellen een derde van de pogingen verknoeien. Wat mij betreft hoort de kolom "alle twintig keer" bij elke agent die boekt. Een leverancier die zo meet, kun je daarop aanspreken.
De taken zijn verzonnen en nog niet nagemeten
Microsoft maakte de test zelf en liet de modellen via Azure draaien. De bedrijven zijn fictief, de taken nagebouwd uit niet-openbare supportcases. De gesimuleerde klant en de beoordelaar van antwoorden zijn GPT-5.4-mini, een broertje van de geteste GPT-5.4. Die klant werkt altijd mee. Bij 477 taken telt alleen de database, dus een verkeerd antwoord aan de klant valt niet op.
Ook veranderde de paper tussen versies hoe hij "alle twintig keer" berekent. De cijfers beschrijven de testomgeving van de auteurs, niet het foutpercentage van agents bij echte bedrijven, schrijft RuntimeWire. Code (MIT) en data (CDLA-Permissive-2.0) staan open, dus iedereen kan het nameten (GitHub).
Volgende Stap
Wil je weten hoe betrouwbaar een agent in jouw proces is? Neem contact op.
Headerbeeld: Microsoft en Hugging Face. Grafieken en rekenblok: AI Centrum Nederland.
Lees ook
Copilot Autopilot gaat zelfstandig aan het werk
Microsoft Copilot Autopilot voert terugkerend werk uit. Wat verandert er, hoe werken de extra kosten en wanneer komt de agent naar Nederland?
AI wordt elk jaar dertien keer goedkoper, meet Epoch AI
Hetzelfde AI-resultaat kost elk jaar 13 keer minder, meet Epoch AI. Dezelfde GPQA-score ging van 30 naar 0,04 cent per vraag. De rekening per taak daalt trager.
Microsoft geeft toekomstige AI een commandolijn
Microsoft legt gedragsregels vast voor toekomstige MAI-modellen. Organisaties mogen configureren, maar niet de harde veiligheidsgrenzen wijzigen.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.