Anthropics Opus 5.5 haalt Fable in en kost minder dan Opus 5
$4 / $20
per miljoen tokens in en uit
66,4%
op Terminal-Bench 4.0
40%
lagere kosten dan Opus 5, volgens Anthropic
Het middelste model haalt het duurste in
Twee maanden geleden kwam Opus 5 uit. Drie weken geleden Fable 5.1, Anthropics duurste model, voor $10 en $50 per miljoen tokens. Vandaag staat er een Opus die op de meeste tests net zo hoog scoort als die Fable, voor minder dan de helft van het geld.
Dat is de kern van deze release. Anthropic zegt het zelf ook zo: het model presteert "op het niveau van Claude Fable 5.1 bij het meeste werk" en kost 40 procent minder om te draaien dan Opus 5 (Anthropic).
Het is ook de eerste release sinds topman Dario Amodei opriep om het tempo aan de grens te drukken. Een model dat een klasse boven Fable uitsteekt, bracht Anthropic dus niet uit. Het bracht het Fable-niveau naar een goedkopere prijsklasse.
Wie liever zelf aan de knoppen zit: hieronder staan de benchmarks, de effort-standen, een kostencalculator en de omleiding van gevoelige vragen in één interactief overzicht. Daarna volgen dezelfde cijfers als tabel en grafiek.
Interactief
Speel zelf met de cijfers van Opus 5.5
Zelfstandig programmeren in een terminal, stap na stap.
6
keer winst voor Opus 5.5
0
keer winst voor Fable 5.1
0
keer winst voor Opus 5
2
keer winst voor GPT-6 Astra
Cijfers van Anthropic, GPT-cijfers volgens OpenAI. "n.b." betekent: niet gepubliceerd.
Deze interactieve uitleg is gebouwd met Claude Opus 5.5.
De vergelijkingstabel
Dit zijn de cijfers die Anthropic naast elkaar zet. Opus 5.5 draaide op de hoogste stand (max), tenzij anders vermeld. De GPT-cijfers komen van OpenAI zelf.
| Test | Wat het meet | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Programmeren als agent | 66,4% | 55,8% | 52,3% | 57,9% |
| FrontierCode v1.1 | Lastige programmeertaken | 54,4% | 50,3% | 48,0% | 53,3% |
| CursorBench 4.0 | Programmeren in een editor | 57,8% | 51,8% | 46,6% | n.b. |
| GDPval-AA v2.1 | Kenniswerk (Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench | Kantoorprocessen | 40,0% | 31,4% | 26,9% | 41,4% |
| Humanity's Last Exam | Alle vakgebieden, met tools | 67,7% | 65,6% | 63,6% | 57,2% |
| Terminal-Bench-Science | Wetenschap als agent | 58,7% | 52,6% | 29,0% | 64,6% |
| OSWorld 2.0 | Een computer bedienen | 81,8% | 80,7% | 74,0% | n.b. |
Opus 5.5 wint zes van de acht rijen. GPT-6 Astra wint er twee: kantoorautomatisering, met 1,4 punt verschil, en wetenschappelijk werk, met bijna 6 punten. OpenAI's goedkopere GPT-5.6 Sol staat ook in Anthropics tabel, maar blijft overal achter; op Terminal-Bench haalt het 37,3 procent.
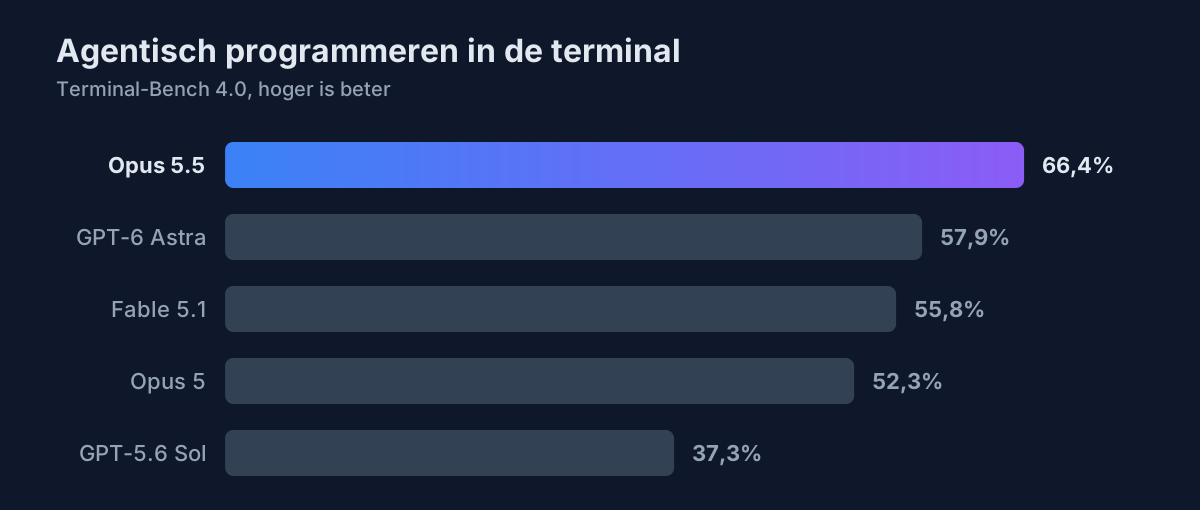
Lees de tabel wel met de kleine lettertjes erbij. Anthropic draaide Opus 5.5 op xhigh voor Terminal-Bench, GPT-6 Astra op high. De foutmarge op die test is 2,6 punt. En AutomationBench liet Zapier draaien zonder terugvalmodel: greep een filter in, dan telde de taak als mislukt. Volgens Anthropic scoort het model in de praktijk daarom hoger dan 40 procent.
Een onafhankelijke meting zegt grotendeels hetzelfde
Alles in de tabel komt van de makers. Artificial Analysis, dat modellen zelf test, komt op een vergelijkbaar beeld uit. Op de Intelligence Index scoort Opus 5.5 op de hoogste stand 58 punten, een record. Fable 5.1 en GPT-6 Astra halen allebei 53 (The Decoder).
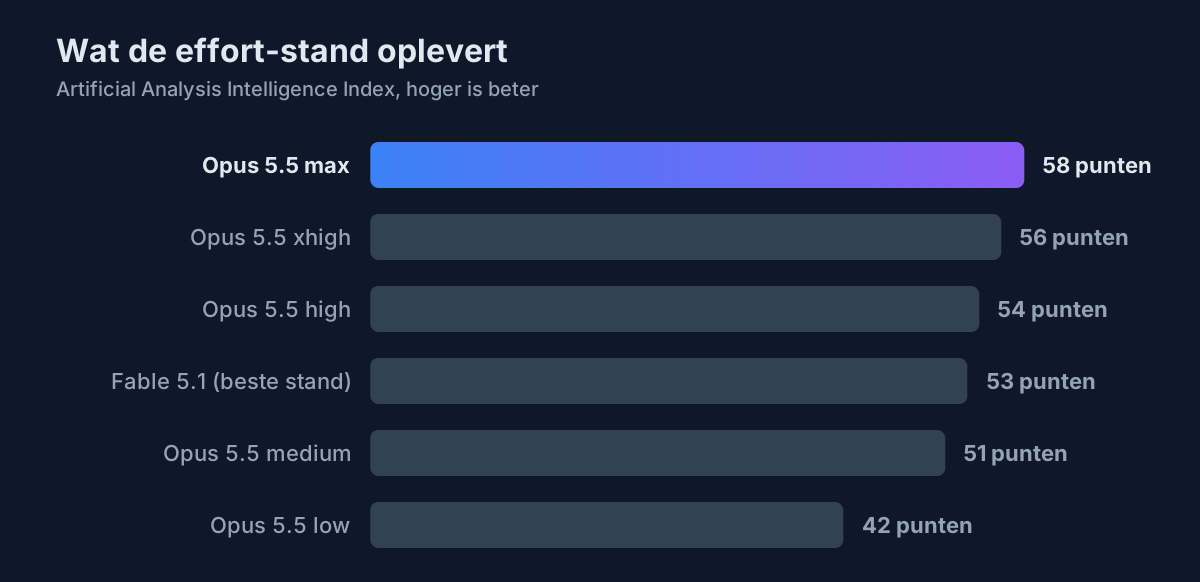
De grafiek laat de rest van het verhaal zien. Opus 5.5 kent vijf standen voor hoe lang het model nadenkt, van low tot max. Al op high scoort het hoger dan Fable 5.1 op zijn beste stand. De standaardstand in de API is medium, met 51 punten.
En hier zit de rekening. Op max gebruikt Opus 5.5 volgens Artificial Analysis zo'n 119.000 uitvoertokens per taak. GPT-6 Astra doet het met 27.000. De lagere prijs per token houdt de kosten per taak concurrerend, maar de hoogste stand is geen koopje. Bij Fable 5.1 pakte die som verkeerd uit: een goedkopere prijslijst en toch een hogere rekening per taak, omdat het model meer schreef.
Een vijfde goedkoper per token, 40 procent volgens Anthropic
De prijzen op een rij, per miljoen tokens:
| Opus 5.5 | Opus 5 | Fable 5.1 | |
|---|---|---|---|
| Invoer | $4 | $5 | $10 |
| Uitvoer | $20 | $25 | $50 |
| Cache lezen | $0,20 | $0,50 | $0,25 |
| Cache schrijven (5 min.) | $5 | $6,25 | n.b. |
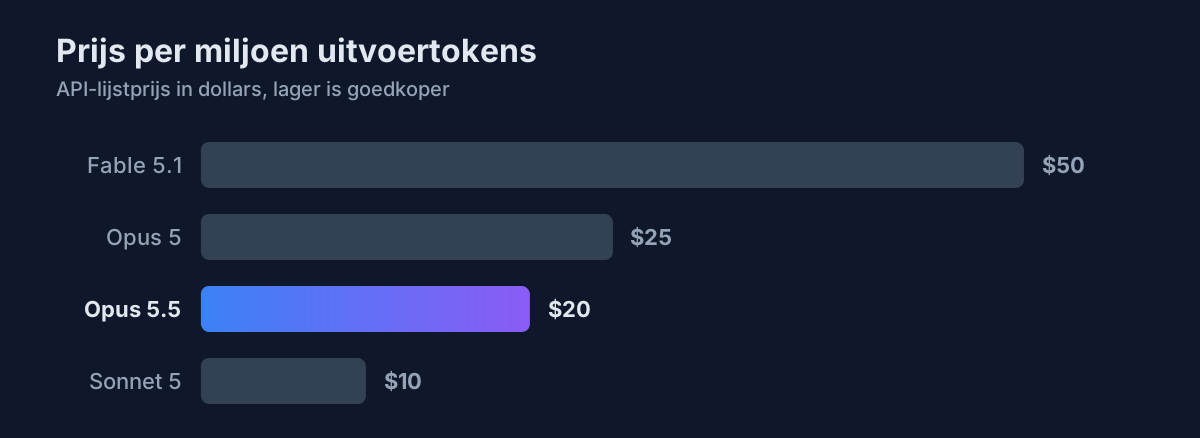
Per token is het 20 procent goedkoper. De 40 procent die Anthropic noemt, komt uit twee dingen samen. De cache wordt 60 procent goedkoper, en dat is het deel dat bij een agent het zwaarst weegt: hij leest bij elke stap dezelfde codebase of hetzelfde dossier opnieuw in. Daarnaast heeft het model minder stappen nodig om klaar te zijn.
Klanten die het vooraf mochten testen, melden dat tweede effect ook. Een voorbeeld van Deloitte:
"Even at its lowest effort setting, Claude Opus 5.5 caught 72% of known bugs in our code reviews to Opus 5's 56% at high effort, with fewer false alarms and a fraction of the output."
— Carl Bennett, CIO van Deloitte Consulting (Anthropic)
Bij datadienst Quantium ging een programmeertaak van 38 prompts over vier dagen naar 11 prompts in drie uur. Dat zijn wel testers die Anthropic zelf uitkoos. Een neutrale steekproef is het niet.
Verder in de specificaties: een contextvenster van 1 miljoen tokens en maximaal 128.000 tokens uitvoer per antwoord. De kennis loopt tot juni 2026, en het model schrijft ruim 30 procent sneller dan Opus 5 (Claude-documentatie). Abonnees op Pro, Max, Team en Enterprise krijgen hogere limieten per vijf uur.
Minder Claude-taal in de antwoorden
Wie veel met Claude werkt, kent de stijl: lange aanlopen, veel opsommingen, de conclusie ergens onderaan. Anthropic pakt dat in deze versie gericht aan. Opus 5.5 zet het belangrijkste vooraan, gebruikt minder jargon en houdt zich beter aan een eigen stijlgids.
"Verbose, hard-to-follow output has been my biggest frustration with frontier models, and Claude Opus 5.5 fixes it. It writes like a good colleague, and follows our writing rules."
— John Ruelas, Staff Software Engineer bij Ramp (Anthropic)
Ik vind dit de interessantste wijziging, meer dan de testscores. Bij de organisaties waar ik kom, loopt AI-gebruik zelden vast op wat het model kan. Het loopt vast op wat mensen ermee doen: een antwoord van twee schermen leest niemand na. Korter en helderder betekent dat collega's het werk van het model beter controleren. Anthropic noemt dat zelf ook een veiligheidswinst.
Welk model je krijgt, hangt af van je vraag
Nu het minder prettige deel. Opus 5.5 draait met dezelfde filters als Fable 5.1. Ziet zo'n filter een vraag over cybersecurity, dan beantwoordt Opus 4.8 hem, een model van een paar generaties terug. Vragen over biologie en over het bouwen van AI-modellen gaan naar Opus 5 (Anthropic).
Voor een beveiligingsteam betekent dat: je betaalt voor Opus 5.5, maar je beveiligingsvraag krijgt een ouder model. De uitgebreidere toegang loopt via Anthropics Cyber Verification Program. Dat was bij de vorige versies alleen open voor Amerikaanse organisaties.
Voor wie software op de API heeft draaien, zijn er vier wijzigingen die bestaande code breken. Nadenken staat altijd aan en kan niet meer uit. Een tool afdwingen geeft een foutmelding. De oude tool voor computerbediening werkt niet meer op de Claude API en Google Cloud. En denkblokken horen bij het model en het gesprek dat ze maakte (migratiegids). Wie van Opus 5 overstapt, moet dus meer doen dan de modelnaam aanpassen.
Wat het betekent voor een Nederlandse organisatie
Opus 5.5 is vanaf vandaag beschikbaar in Claude en via de API, Amazon Bedrock, Google Cloud en Microsoft Foundry. Zero-retentie, waarbij Anthropic je gegevens niet bewaart, blijft mogelijk, net als bij eerdere Opus-modellen. Bij Fable 5.1 was dat juist niet zo. Anthropic past ook de watermerken toe die de EU AI Act vraagt.
Daarmee valt voor veel werk het argument voor Fable 5.1 weg. Dat model was sterker, duurder en had een bewaarplicht van dertig dagen. Opus 5.5 is op de meeste tests even sterk, kost 60 procent minder per token en bewaart niets als je dat afspreekt. Voor zakelijk gebruik met klantgegevens is dat een groot verschil.
Sonnet 5.5 en Haiku 5.5 volgen "in de komende weken", schrijft Anthropic. Die lichtere modellen draaien het meeste dagelijkse werk. Als de verbeteringen daar ook landen, merken meer gebruikers er iets van dan nu met alleen de Opus.
Volgende Stap
Een nieuw model is snel aangezet. Welke stand je draait, welk model welke taak krijgt en wat dat per afgeronde taak kost, dat vraagt om rekenwerk in je eigen processen. Dat doen we graag samen met je, onafhankelijk van welk lab je kiest.
→ Plan een AI Strategie Sessie.
Bronnen: Anthropic, Claude-documentatie, Artificial Analysis, The Decoder, TechCrunch en VentureBeat. Headerbeeld en video: Anthropic. Grafieken: AI Centrum Nederland, op basis van cijfers van Anthropic en Artificial Analysis.
Lees ook

Opus 5 verslaat Fable 5 voor half geld, zegt Anthropic
Claude Opus 5 kost $5 per miljoen invoer-tokens, de helft van Fable 5, en staat op zeven van de twaalf tests bovenaan. De cijfers komen wel van Anthropic zelf.

Anthropic knijpt de Claude-limieten: Pro-gebruikers gaan per token betalen
Vanaf 20 juli halveert Anthropic de Fable 5-limieten in Max en Team, en Pro-gebruikers vallen terug op API-prijzen. Reken je Claude-verbruik opnieuw door.
Claude Projects stuurt nu meerdere agents tegelijk aan
Anthropic bouwt Claude Projects om tot een coördinator voor parallelle Claude Code-sessies, elk met een eigen branch, geheugen en gebruik.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.