Claude Code review: risico bepaalt hoeveel mensen kijken
In het team dat Claude Code bouwt, schrijft Claude zelf ongeveer 90 procent van de code. Dat is een eigen opgave van Anthropic, zonder meetmethode. Er komt meer code bij dan mensen kunnen lezen.
Addy Osmani, Morgan Westlee Lunt en Qing Wang beschreven op 15 oktober in "How the Claude Code team does code review" hoe het team dat oplost (claude.dev). Simon Willison citeerde het een dag later (simonwillison.net) zonder eigen commentaar: een tweede vermelding, geen controle.
Waarom review het knelpunt werd
In Anthropics grote codebase steeg het aantal wijzigingen per dag van ongeveer 2.500 in mei naar meer dan 30.000 in september. In de aparte codebase van Claude Code verdubbelde het aantal samengevoegde pull requests (PR's: voorgestelde wijzigingen) van juni tot september ruim.
Het doel: de meeste PR's samenvoegen met hooguit één mens, en dat mag de auteur zijn, zonder meer teruggedraaide PR's (reverts) of incidenten.
Zo werkt Claude Code review: agents zoeken, andere stemmen
Vóór de PR draait Claude de tests en controles, en bekijkt een tweede agent de wijziging met een verse context. Op de PR zoeken meerdere agents tegelijk naar bugs. Andere agents stemmen over elke vondst; alleen wat genoeg stemmen haalt, wordt gepost. Ernaast loopt een aparte security review. Het team voegt niets samen zolang een bevinding uit een van beide openstaat.
Boris Cherny, de maker van Claude Code, noemt verificatie volgens Anthropic waarschijnlijk het belangrijkste voor een goed resultaat. Het maakt de uitkomst volgens hem twee tot drie keer beter.
"Verification looks different for each domain. It might be as simple as running a bash command, or running a test suite, or testing the app in a browser or phone simulator."
— Boris Cherny, maker van Claude Code (geciteerd door Anthropic)
Een classifier bepaalt hoeveel mensen kijken
Een classifier deelt elke wijziging in op risico.
| Niveau | Voorbeelden | Mensen |
|---|---|---|
| Laag | docs, tekst, interne functies, toevoegingen achter een schakelaar | 0 |
| Midden | productwijziging, gevoelige delen zoals caching | 1 |
| Hoog | riskantste code, delen die altijd twee mensen vragen | 2 |
Laag is alleen 0 als beide reviews groen zijn. "The change sets the tier, not the author", schrijft het team. Direct daarna volgt een uitzondering: alleen auteurs op de vertrouwde lijst van het project, vooral het team dat het beheert, krijgen de lichte routes. Bij anderen keurt iemand anders dan de auteur goed.
Een tweede classifier kan alsnog een mens vragen. Bestanden die het automatisch bouwen en uitrollen regelen (CI-workflowbestanden) en paden die eigenaren als gevoelig markeren, krijgen altijd een mens. De goedkeuring van een agent telt nooit als die van een mens. Vraagt het niveau een mens, dan telt wie de agent aanstuurde als een van de verplichte reviewers. En een goedkeuring geldt voor één commit: één specifieke versie van de wijziging.
Zo pakt dat per soort wijziging uit:
Interactief
Welke review-route krijgt deze wijziging?
Kies een soort wijziging. Het blok toont het risiconiveau en hoeveel mensen nog goedkeuren.
Uitkomst
- Risiconiveau
- Midden
- Menselijke goedkeuringen
- 1
- Eén persoon keurt goed.
- Een tweede classifier kan toch een mens vragen, ook als het niveau dat niet eist.
Geldt altijd
- De goedkeuring van een agent telt nooit als die van een mens.
- Een goedkeuring geldt voor één specifieke versie van de wijziging (een commit). Komen er commits bij die het systeem niet kan controleren, dan opnieuw.
- De wijziging bepaalt het niveau, niet de auteur. Alleen auteurs op de vertrouwde lijst krijgen de lichte routes.
Regels van het Claude Code-team zoals Anthropic ze beschrijft, geen advies voor jouw organisatie. Bron: claude.dev, 15 oktober 2026. Blok: AI Centrum Nederland.
Wat het opleverde, volgens Anthropic
Het begon met een ontsporing: één PR ging 's nachts door meer dan vijftig rondes review en fix, tot de auteur hem stopte. Het team bouwde remmen in: na drie rondes vraagt de reviewer de auteur de aanpak te heroverwegen. Na de eerste paar rondes kijkt hij alleen nog naar nieuwe wijzigingen.
Het aandeel PR's dat na één ronde review en fix slaagt, steeg van 65 naar 78 procent. PR's met vijf of meer rondes daalden van 8,9 naar 1,5 procent. Van juni tot september daalde het aandeel teruggedraaide PR's in Claude Code met meer dan 40 procent. Dat is relatief: het absolute percentage noemt Anthropic niet.
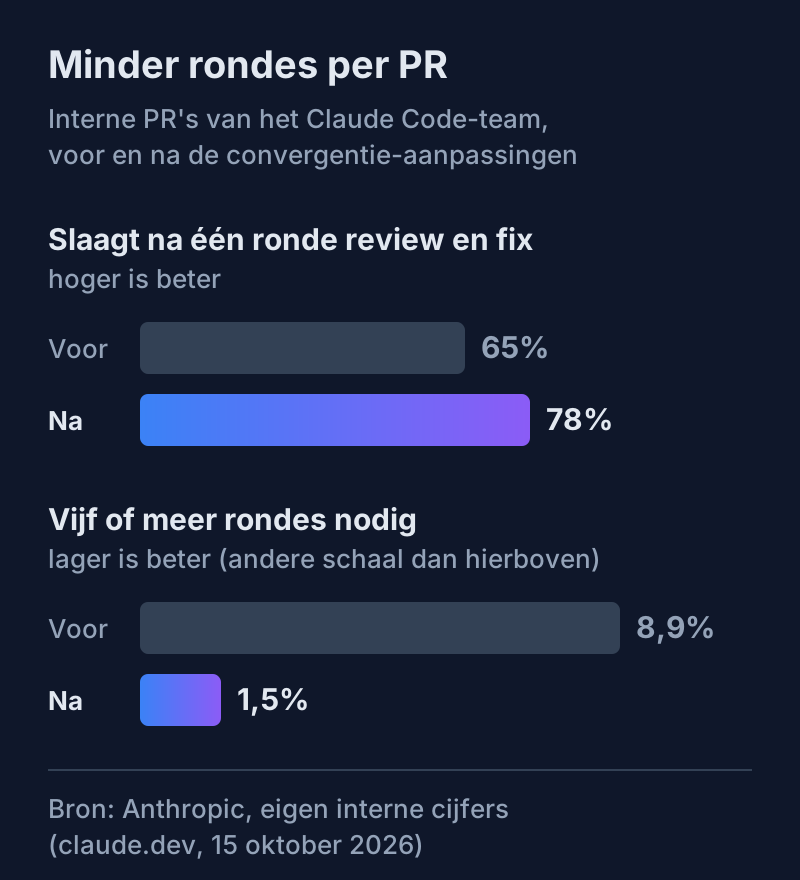
Periode en aantal PR's noemt Anthropic niet. De AI-reviewer zelf wordt elke dag gescoord tegen eerdere PR's die incidenten of reverts veroorzaakten. Een aanpassing blijft alleen als die score stijgt.
Wat Anthropic zelf nog niet heeft
Het scherpste tegengeluid komt van het team zelf: "We don't yet have circuit breakers that tighten approval when those numbers move." Een rem die vanzelf strenger wordt als reverts of incidenten oplopen, is er dus nog niet. De eigen engineers willen die eerst, voordat meer code zonder mens wordt samengevoegd.
Een verkeerde indeling weegt het zwaarst bij nul goedkeuringen. Hoe de classifier werkt en hoe vaak hij misgrijpt, staat nergens. Het doel noemt reverts én incidenten; gepubliceerd is alleen de daling in reverts. Kritisch commentaar op het stuk vond ik niet.
Code Review for Claude Code keurt een PR nooit goed en blokkeert hem niet; de beslissing blijft bij het team (documentatie). Samenvoegen zonder mens is Anthropics eigen keuze, geen knop in het product. Het werkt alleen via GitHub, op Team- en Enterprise-abonnementen. Betalen gaat per token via usage credits (kosten).
Wat dit zegt over bouwen met AI of een leverancier
Wie code laat schrijven door Copilot, Claude Code of een leverancier, krijgt dezelfde drie vragen. De verschillen tussen die tools: Copilot Code tegenover Claude Code.
Wie bepaalt het risico? Bij Anthropic een classifier, plus eigenaren die paden als gevoelig aanmerken. Bij een leverancier is dat een contractvraag: wie stelt het niveau vast, en wie tekent af. Dat hoort bij de afspraken uit onze AI-governance checklist.
Waar blijft de mens? De stevigste regel: een bot telt nooit als mens, en wie de agent aanstuurt is verantwoordelijk. Met meer agents tegelijk, zoals bij Claude Projects, wordt die vraag groter.
Wat leg je vast? Code-eigenaren schrijven een REVIEW.md. De goede zijn kort, zeggen hoe falen eruitziet ("for docs it's 'it lies,' for config it's 'it misroutes'"), beperken de kleine stijlpunten en vragen bestand en regelnummer als bewijs. Het product leest dat bestand van de hoofdbranch, dus een PR kan zijn eigen reviewregels niet versoepelen.
Volgende Stap
Laat je software bouwen door een leverancier of met AI-agents? Neem contact op, dan zetten we de review-afspraken samen op papier.
Headerbeeld: Anthropic (claude.dev). Grafiek: eigen weergave van cijfers van Anthropic.
Lees ook
Anthropic beursgang: wat verandert er voor Claude-klanten?
Anthropic beursgang: het verlies van $80,7 mld is grotendeels papier. Wat de S-1 zegt over je Claude-contract, het cloudkanaal en je exit-route.
Anthropic haalt eerste eigen juridisch baas voor Claude binnen
Anthropic stelt Robert Mahari aan als eerste Head of Claude for Legal. Voor EU-kantoren blijft dataresidentie en beroepsgeheim een eigen huiswerkopgave.
Claude Enterprise checkt prompts nu op je eigen server
Claude Enterprise stuurt elke prompt eerst naar je eigen securityserver. Zo werken inference hooks, wat ze niet kunnen en wat er gebeurt bij een storing.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.