DeepSeek V4.1 Flash snijdt 75 procent uit zijn contextcache
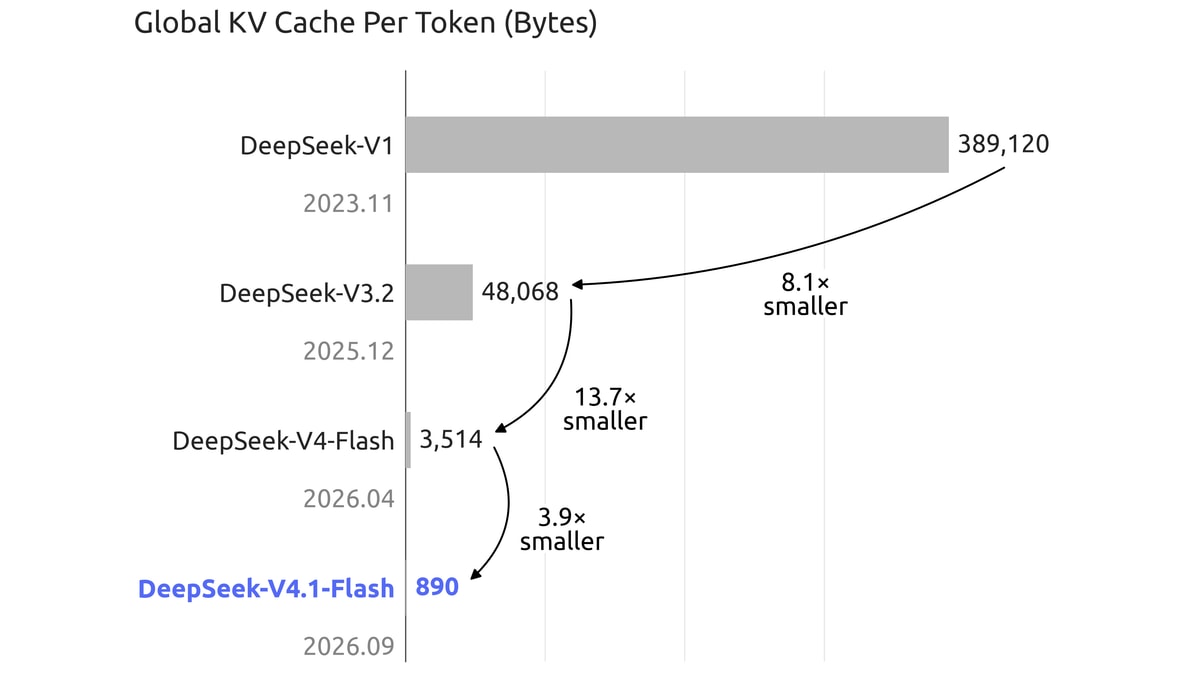
DeepSeek heeft een geheugenprobleem aangepakt dat steeds groter wordt naarmate AI-agents langer werken. V4.1 Flash gebruikt volgens de officiële release nog 890 bytes globale KV-cache per token. Bij V4 Flash was dat 3.514 bytes.
Dat is bijna 75 procent eraf.
De claim die daar snel achteraan komt, is verleidelijk: vier keer minder geheugen, dus vier keer minder GPU's. Zo simpel is het niet. De cache krimpt spectaculair. Het model zelf niet.
890 bytes
globale KV-cache per token bij V4.1 Flash
3.514 bytes
per token bij V4 Flash
75% minder
globale KV-cache per token
1/4 HBM
voor cache volgens DeepSeek
1/8 SSD
voor persistente cache volgens DeepSeek
Een miljoen tokens kost nog 890 MB cache
Een taalmodel bewaart tijdens het genereren tussenresultaten van eerder verwerkte tokens. Dat heet de KV-cache. Zonder die cache zou het model bij ieder nieuw woord veel van het eerdere rekenwerk opnieuw moeten doen. Hugging Face legt het mechanisme hier uit.
Die cache wordt vooral interessant bij lange sessies. Een agent die een groot projectdossier, codebase of langdurige taakgeschiedenis vasthoudt, sleept veel context mee.
DeepSeek rapporteert voor V4.1 Flash 890 bytes globale KV-cache per token. Op basis van dat cijfer komt één context van een miljoen tokens uit op ongeveer 890 MB. Bij V4 Flash is dat ongeveer 3,5 GB.
| Globale KV-cache | V4 Flash | V4.1 Flash |
|---|---|---|
| Per token | 3.514 bytes | 890 bytes |
| 1 miljoen tokens | 3,514 GB | 0,890 GB |
| 100 aparte contexten van 1 miljoen tokens | 351,4 GB | 89,0 GB |
Die laatste regel is een rekenvoorbeeld, geen serverbenchmark. Hij telt alleen de gepubliceerde globale KV-cache. Modelgewichten, lokale cache, buffers en andere overhead zitten er niet in.
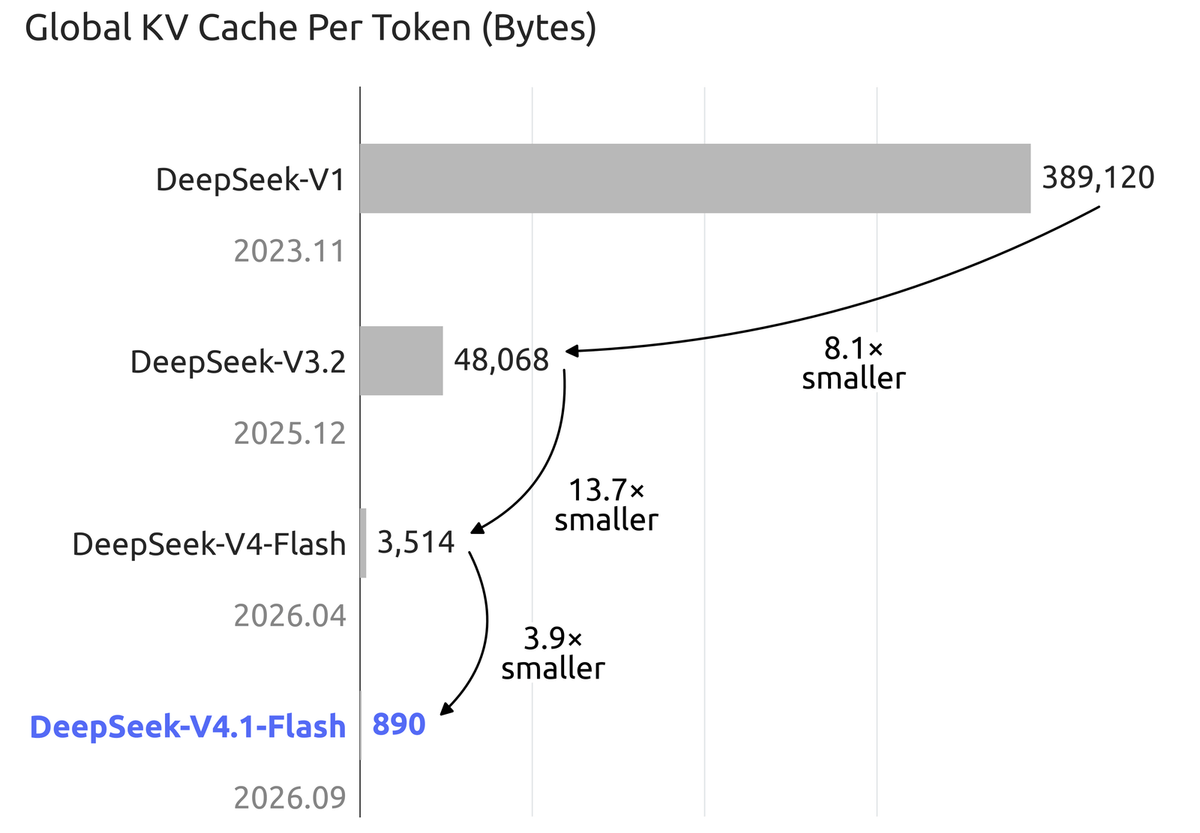
Bekijk de originele figuur bij DeepSeek.

De sprong wordt nog groter als DeepSeek verder terugkijkt. V1 zat volgens dezelfde grafiek op 389.120 bytes per token. V4.1 Flash zit op 890. Dat is ruim 400 keer minder. Voor de vergelijking met de directe voorganger is 75 procent het eerlijkere getal.
DeepSeek ruilt opslag in voor selectiever rekenen
De reductie komt niet uit één truc. In het technische rapport beschrijft DeepSeek onder meer gedeelde cachegegevens tussen lagen en compacte opslag van de globale cache. Voor langdurig bewaarde context hoeft bovendien niet ieder lokaal cacheonderdeel permanent opgeslagen te blijven. Een deel kan bij hervatting opnieuw worden berekend.
Dat is een echte trade-off: minder geheugen en opslag, tegenover extra rekenwerk wanneer context opnieuw moet worden opgebouwd.
DeepSeek vat de hardwareclaim zelf scherper samen. De nieuwe generatie zou voor cache ongeveer een kwart van de HBM-capaciteit en een achtste van de SSD-capaciteit van de vorige generatie nodig hebben (DeepSeek).
HBM is het snelle geheugen naast de AI-chip. Juist dat geheugen is duur en schaars. Als cache daar minder ruimte inneemt, kan dezelfde hardware meer lange sessies tegelijk vasthouden.
Maar "een kwart HBM" betekent hier niet dat een complete V4.1-server nog een kwart van het GPU-geheugen nodig heeft. Het percentage gaat over de cachecomponent.
Het model zelf werd juist groter
Hier zit de nuance die de spectaculaire grafiek mist.
V4.1 Flash is geen klein model dat opeens op een doorsnee GPU past. De officiële modelrepository beschrijft 552 miljard hoofdparameters, plus een groot Engram-geheugen. De downloadbestanden beslaan samen ongeveer 510 GB.
Het model gebruikt een Mixture-of-Experts-architectuur. Daardoor hoeft per token maar een deel van alle parameters actief mee te rekenen. DeepSeek noemt 8 miljard actieve parameters bij het verwerken van invoer en 16 miljard tijdens generatie (DeepSeek).
Dat verlaagt de hoeveelheid rekenwerk. Het betekent niet dat de overige gewichten niet ergens opgeslagen hoeven te worden.
De actuele vLLM-recepten laten precies die spanning zien. Voor deployment worden configuraties beschreven met onder meer vier GB200's of acht H200's. Er zijn ook configuraties waarbij Engram-tabellen naar gewoon CPU-geheugen worden verplaatst. SGLang documenteert een vergelijkbare route voor CPU-offloading van Engram.
De hardwarevraag verdwijnt dus niet. Hij verandert van vorm: hoeveel snel GPU-geheugen is nodig voor actieve berekeningen en cache, hoeveel kan in normaal servergeheugen staan, en hoeveel gelijktijdige lange contexten moet het systeem bedienen?
Honderd lange agents laten zien waarom dit telt
Neem honderd afzonderlijke agents, elk met een context van een miljoen tokens. Alleen de globale KV-cache komt met de gepubliceerde cijfers uit op ongeveer 351 GB bij V4 Flash. Bij V4.1 Flash is dat 89 GB.
Dat scheelt in dit rekenvoorbeeld ruim 262 GB cachegeheugen.
Dat is niet hetzelfde als 262 GB minder GPU-geheugen kopen. DeepSeek verdeelt cache over verschillende geheugenlagen en een productieomgeving heeft meer componenten. Het getal laat wel zien waarom de architectuur interessant wordt zodra AI van korte chats naar langdurige agents beweegt.
Een chatbot die tien vragen beantwoordt, heeft een ander geheugenprofiel dan honderd software-agents die uren aan code werken. De tweede categorie maakt cache-efficiëntie veel belangrijker.
Daar zit volgens mij het grotere verhaal achter deze release. De markt kijkt meestal naar modelkwaliteit en tokenprijs. Bij langdurige agents komt daar een derde variabele naast: hoeveel geheugen kost het om al die context levend te houden?
Bij OpenDesign zit V4.1 Flash bijna op Astra, voor veel minder geld
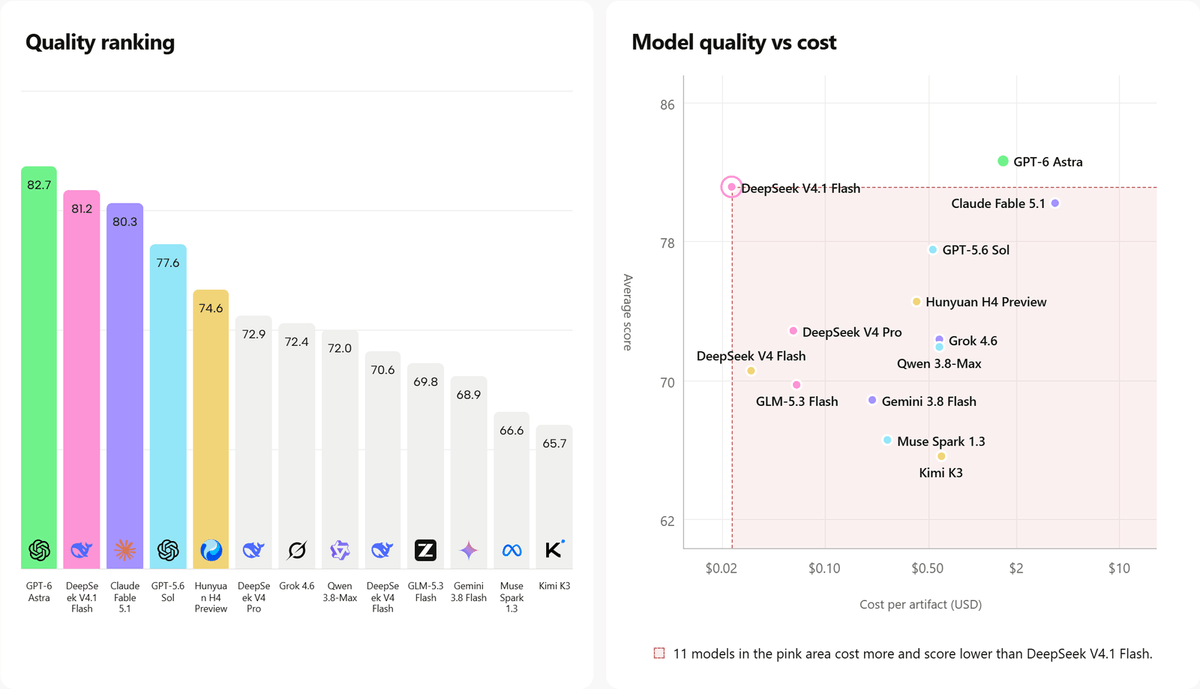
De tweede grafiek die rondgaat is minstens zo opvallend. OpenDesign vergelijkt modellen op digitale ontwerp- en prototypetaken. In die evaluatie scoort DeepSeek V4.1 Flash gemiddeld 81,2. GPT-6 Astra komt op 82,7.
De geschatte kosten per artifact liggen veel verder uit elkaar.
| OpenDesign-evaluatie | Gemiddelde score | Kosten per artifact |
|---|---|---|
| DeepSeek V4.1 Flash | 81,2 | $0,023 |
| GPT-6 Astra | 82,7 | $1,61 |
Bekijk de actuele ranglijst en onderzoeksmethode bij OpenDesign.
Op deze test behaalt DeepSeek daarmee ongeveer 98 procent van Astra's score tegen circa 1,4 procent van de geschatte kosten. Dat klinkt bijna absurd goedkoop.
Het is alleen geen bewijs dat DeepSeek "98 procent zo intelligent" is. OpenDesign meet een specifieke categorie: ontwerpkwaliteit en het volgen van ontwerpvragen. De kosten zijn gebaseerd op tokengebruik en API-tarieven. Hardware, energie en alle andere soorten AI-werk zitten daar niet in.
Dat onderscheid is belangrijk. De grafiek bewijst geen algemene winnaar. Hij laat wel zien hoe ver prijs en gemeten kwaliteit bij één concrete workload uit elkaar kunnen lopen.
De API laat dezelfde kostenrichting zien
Zelf hosten is bovendien niet de enige manier om hiervan te profiteren. DeepSeek biedt V4.1 Flash via zijn API aan. De actuele prijspagina noemt buiten piekuren $0,15 per miljoen niet-gecachete invoertokens en $0,60 per miljoen uitvoertokens. Tijdens piekuren is dat respectievelijk $0,30 en $1,20.
Gecachete invoer is nog goedkoper: $0,003 buiten piekuren en $0,006 tijdens piekuren per miljoen tokens.
Daarmee raken twee ontwikkelingen elkaar. De architectuur drukt de geheugenlast van lange context. De commerciële API maakt dezelfde modelklasse goedkoop toegankelijk zonder dat een bedrijf zelf een rack met accelerators hoeft neer te zetten.
Voor veel organisaties zal dat laatste voorlopig relevanter zijn dan het kopen van H200's. Voor partijen die modellen op eigen infrastructuur draaien, wordt de cachearchitectuur juist onderdeel van de capaciteitsplanning.
Dit maakt GPU's niet overbodig
Een reductie van 75 procent in globale KV-cache is geen reductie van 75 procent in stroomverbruik, serverkosten of benodigde GPU's. Daarvoor zijn de gepubliceerde cijfers te smal.
Hetzelfde geldt voor training. De cijfers gaan over inference: het draaien van een getraind model. Ze zeggen niet dat het trainen van frontier-modellen opeens vier keer minder hardware kost.
Wat wel meetbaar is, is de richting. DeepSeek heeft de hoeveelheid globale contextcache per token van 3.514 naar 890 bytes gebracht. Bij workloads met veel lange, gelijktijdige contexten haalt dat een flinke hoeveelheid geheugen uit de vergelijking.
En precies daar groeien AI-systemen naartoe. Niet één prompt, één antwoord en klaar. Agents houden dossiers vast, gebruiken tools, schrijven code en blijven langer actief. Als die vorm van AI doorzet, wordt cache-efficiëntie net zo'n relevante specificatie als contextlengte en tokenprijs.
V4.1 Flash maakt die specificatie ineens zichtbaar.
Volgende Stap
De hardware achter AI wordt niet alleen bepaald door hoe groot een model is. Contextlengte, gelijktijdige agents en cachearchitectuur gaan steeds zwaarder meetellen in de kosten van een AI-systeem.
Liever sparren over je eigen situatie? Plan een vrijblijvend gesprek.
Bronnen: DeepSeek V4.1 Flash, technisch rapport, DeepSeek op Hugging Face, vLLM, SGLang, OpenDesign en DeepSeek API-prijzen. Beelden: DeepSeek en OpenDesign.
Lees ook
OpenAI lanceert GPT-6 Astra en roept het AGI-tijdperk uit
OpenAI noemt GPT-6 Astra het begin van het AGI-tijdperk. Wat het model echt kan, wat het kost, en waarom het als eerste hun cyberdrempel kritiek haalt.
Anthropics Fable 5.1 wordt goedkoper per token, en duurder per taak
Anthropic snijdt 75 procent van de cacheprijs en belooft tot 45 procent besparing. Artificial Analysis meet 20 procent meer kosten per taak.
AI-agents verstoken vijf keer meer tokens dan mensen
Op OpenRouter draaien agents 7,3 biljoen tokens per week, tegen 1,4 biljoen voor mensen. Sinds februari ging dat verbruik veertien keer over de kop.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.