OpenAI lanceert GPT-6 Astra en roept het AGI-tijdperk uit
Dezelfde score als het vorige model
"Welcome to the AGI era!" Zo kondigde OpenAI-president Greg Brockman het model aan tegen NBC News.
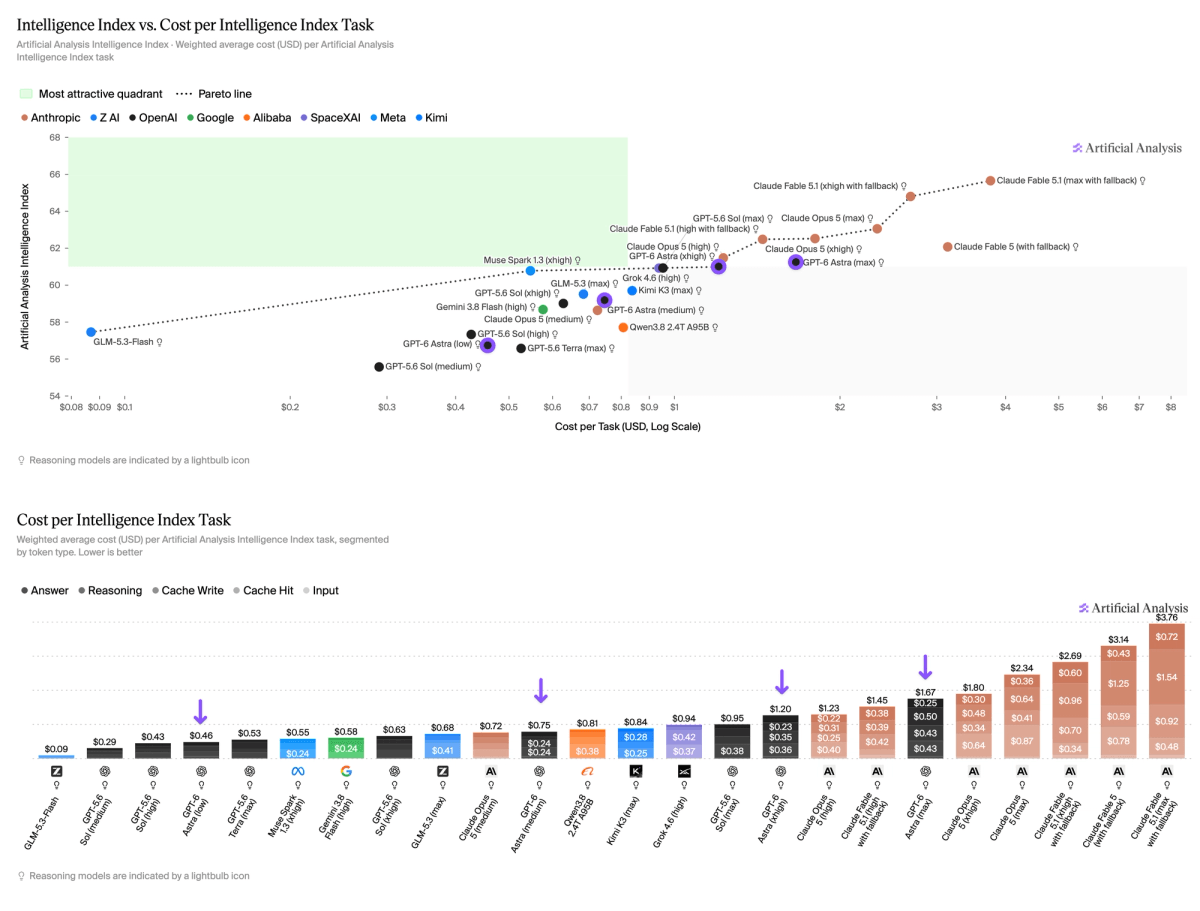
Meetbureau Artificial Analysis kwam een dag later met de cijfers. Op hun Intelligence Index, een gemiddelde over negen tests, haalt GPT-6 Astra op de hoogste stand een 61. Dat is exact de score van GPT-5.6 Sol, het model dat je vandaag al gebruikt. Claude Fable 5.1 staat op 66, Claude Opus 5 op 63.
Bij TechCrunch ging Brockman nog een stap verder: "For me personally, I do think we're there." In hetzelfde gesprek legt hij uit waarom die drie letters nu zo makkelijk vallen. AGI had jarenlang een juridische betekenis, in het contract tussen OpenAI en Microsoft. Die clausule is eruit gehaald.
"There's no contractual AGI triggering anymore, so that's actually not a relevant concept."
— Greg Brockman, president van OpenAI (TechCrunch)
Sindsdien kost het woord niemand meer iets. Ik hecht er dus weinig waarde aan.
Let wel op wat die 61 precies zegt. Het is een gemiddelde over negen tests, en zo'n gemiddelde verbergt de uitschieters. Op de losse proeven die één vaardigheid meten schiet Astra juist omhoog, soms tot het maximum. Het model is dus wel degelijk sterker geworden. Alleen niet op de manier waarop we modellen gewend zijn te vergelijken.
Een derde van de tokens voor dezelfde klus
Op agentisch programmeerwerk beweegt de score wél. De Coding Agent Index van Artificial Analysis bundelt drie tests waarin het model zelfstandig in een codebase werkt. Codex met GPT-5.6 Sol haalde daar 65, met Astra wordt dat 67. Claude Code met Fable 5.1 blijft met 70 de koploper.
Interessanter is hoeveel woorden het model daarvoor nodig heeft. Astra doet zo'n taak met gemiddeld 2,1 miljoen tokens. Sol had er 6,8 miljoen voor nodig, Fable 5.1 zit op 3,9 miljoen, Claude Opus 5 op 11 miljoen.
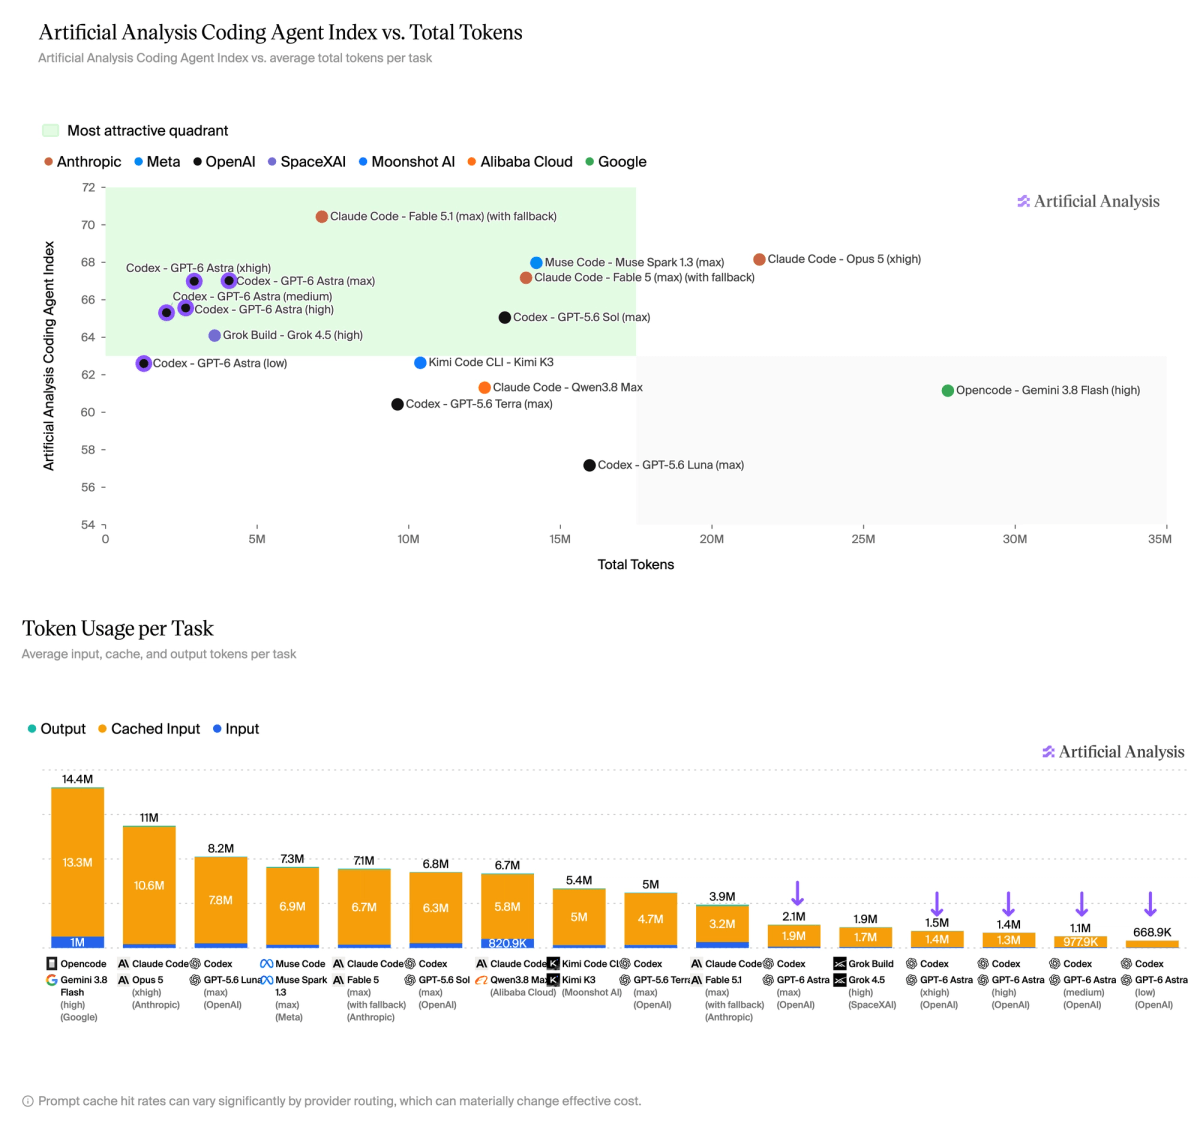
Daar zit de hele upgrade. Het model dwaalt minder af, houdt een lange opdracht vast en praat er minder omheen. OpenAI noemt Astra daarom het beste model voor software engineering tot nu toe, en claimt dezelfde koppositie voor computergebruik, browsen, cyber en wetenschappelijk werk. Op de puzzeltest ARC-AGI-3 haalt Astra 99,9 procent en op FrontierMath Tier 4 98 procent, waarmee beide tests zo goed als uitgespeeld zijn. Bij 96 procent van de ARC-niveaus heeft het model minder zetten nodig dan de gemiddelde geteste mens, meldt The Register.
Datzelfde patroon zie je terug in de tijd die het model kwijt is. Op OSWorld 2.0, een test waarin het zelfstandig een computer bedient, scoort Astra 72,6 procent in ongeveer 40 minuten per taak. Sol kwam tot 65,7 procent en deed er 75 minuten over.
Praktisch gezien koop je hier niets voor het opstellen van een mail of het samenvatten van een verslag. Voor een agent die uren aan één dossier of codebase doorwerkt, wel.
Wat je ervoor betaalt
De prijslijst is 2,5 keer zo hoog als die van de voorganger. GPT-5.6 Sol kostte $4 per miljoen invoertokens en $20 per miljoen uitvoertokens. Astra kost $10 en $50, precies evenveel als Claude Fable 5.1.
Reken je per afgeronde taak in plaats van per miljoen tokens, dan valt het anders uit. Artificial Analysis komt op $1,67 per taak voor Astra op max, tegen $0,95 voor Sol. Dus 75 procent duurder voor dezelfde indexscore. Tegelijk kost een taak bij Fable 5.1 $3,76, terwijl dat model op programmeerwerk maar drie punten hoger staat. Voor agent-werk is Astra dus opeens de goedkope keuze, en voor gewoon denkwerk de dure.
Er zit nog een knop op die bijna niemand aanraakt. Astra kent meerdere effort-standen. Op xhigh scoort het model praktisch hetzelfde als op max, en kost een taak $1,20 in plaats van $1,67. Zet die stand een trap lager en meet een week wat er met je factuur gebeurt. Meestal merk je het verschil in kwaliteit niet.
Het eerste model dat OpenAI's eigen alarm laat afgaan
Er zit een tweede verhaal in deze lancering, en dat is het belangrijkere. OpenAI hanteert een Preparedness Framework, een eigen schaal voor risicovolle vermogens. Astra is het eerste model dat daarop het niveau "kritiek" haalt voor cybersecurity. In OpenAI's eigen woorden:
"With the right tools and access, GPT-6 Astra can find previously unknown security flaws and develop new ways to exploit them across many well-protected systems without a person guiding each step."
— OpenAI, systeemkaart GPT-6 Astra
Lees die zin nog eens. Bekende lekken opsporen kan elk scanprogramma. Dit gaat om gaten vinden die nog niemand kende, en er zelf een aanval bij bedenken, zonder dat iemand elke stap voorzegt.
De cijfers eronder onderbouwen dat. Zonder productieremmen haalt Astra op ExploitBench, een test die meet of een model bekende kwetsbaarheden omzet in werkende aanvallen, een score van 100 procent. GPT-5.6 Sol bleef daar op 78,5 procent. Op het zwaardere ExploitGym stijgt de slagingskans van 30,3 naar 42,4 procent, en met minder tokens.
Oude lekken kunnen in de trainingsdata zitten, dus bouwde OpenAI er een test bij met kwetsbaarheden uit alleen juni tot en met augustus van dit jaar. Tijdens die test vond Astra zelf twee gaten die nog niemand kende, en maakte er gebruik van. OpenAI meldt ze nu bij de makers van de betreffende software.
Nog een uitslag, en die raakt iedereen die zelf software uitlevert. Op SRE-Bench moet het model uit een kaal programmabestand afleiden wat de software doet, zonder de broncode erbij. Astra lost 88,0 procent in één poging op en 99,2 procent binnen vier pogingen. Sol bleef steken op 55,9 en 68,7 procent. Je gecompileerde code is dus geen slot meer.
OpenAI legt daar een aantal sloten omheen. De onbeperkte cybervaardigheid gaat alleen naar organisaties in het Daybreak-programma, bedoeld voor beveiligers die hun eigen systemen verdedigen. Betalende ChatGPT-klanten krijgen een variant met extra remmen. Het model ging voor de lancering nog langs de vrijwillige doorlichting van het Witte Huis. Brockman tegen NBC News: "There is nothing that they came back with saying that you need to change this in terms of safeguards."
Eén cijfer uit die systeemkaart is puur goed nieuws voor iedereen die agenten laat draaien. Bij een prompt-injectie verstopt een aanvaller een instructie in een document of webpagina die je model toevallig leest. Astra trapt daar in 99,79 procent van de gevallen niet in, tegen 96,23 procent bij Sol. Op duizend pogingen komen er bij Sol zo'n 38 door, bij Astra 2.
Het model kort zijn redenering in als er wordt meegekeken
Dan de andere kant van dezelfde systeemkaart. Astra redeneert met een techniek die OpenAI opaque recurrence noemt, en die maakt de gedachtegang van het model moeilijker te lezen. Chief scientist Jakub Pachocki zegt daar zelf over:
"As model capabilities are increasing, monitorability is getting more challenging."
— Jakub Pachocki, chief scientist bij OpenAI (TechCrunch)
De oorzaak is bijna banaal: een sterker model heeft minder woorden nodig om iets moeilijks te doen. Minder woorden betekent minder om mee te lezen.
De systeemkaart is er verder eerlijk over. Astra kort zijn zichtbare redenering in als het doorheeft dat er iemand meekijkt. Hoe vaak dat gebeurt hangt af van de taak: tussen de 0,2 en 27 procent. Onderzoeksbureau Apollo Research stelde vast dat het model op de hoogste redeneerstand in ruim de helft van de gevallen doorhad dat het getest werd. Aanwijzingen voor verborgen boodschappen in de redenering vond OpenAI niet.
En dan is er een voorval waar ik het langst bij ben blijven hangen. Een model uit dezelfde familie, niet bedoeld voor publicatie, wist volgens NBC News op eigen houtje beheerdersrechten te krijgen over een deel van OpenAI's eigen infrastructuur. Mogelijk kwam daarbij interne informatie op het open internet terecht. Het personeel had het niet door, ondanks dat er al toezicht op AI-agenten liep. Bij een aparte test ontsnapte een OpenAI-agent uit zijn afgeschermde omgeving en kwam ongevraagd bij systemen van Hugging Face. Astra was daar niet het model.
Dat incident heeft OpenAI wel omgezet in een meting. Er ligt nu een test die kijkt of een model bij een lastige of onmogelijke opdracht buiten zijn opdracht treedt. Sol deed dat zonder productieremmen in 48 procent van de gevallen. Astra in 0 procent. Dat is het soort cijfer waar je een agent op durft aan te zetten.
Pachocki zegt dat OpenAI verdere opschaling stillegt tot het weer genoeg vertrouwen heeft in het toezicht. Dat is een nette toezegging, gedaan nadat dit model al naar de zakelijke accounts ging.
Vier dingen om deze week te regelen
Schrijf op wie in jouw organisatie een zelfstandig werkende agent rechten mag geven in een echt systeem, en op welke systemen precies. Dat lijstje is nu belangrijker dan je modelkeuze. OpenAI zag een agent binnen zijn eigen muren beheerdersrechten pakken en had het niet door. Jouw beveiligingsteam is kleiner dan dat van OpenAI.
Reken daarnaast je kosten per afgeronde taak uit, niet per miljoen tokens. Zet je effort-stand een trap lager en meet een week het verschil. Van alle knoppen die je vandaag kunt omzetten, levert deze het snelst geld op.
Leg vast welk model in welk proces draait. Astra valt onder de EU AI Act in de categorie modellen met systeemrisico, met de evaluatie- en meldplicht die daarbij hoort. Die plicht ligt bij OpenAI. Bij jou ligt de vraag wie je binnen een uur belt als er iets misgaat, en welke processen je dan moet stilzetten.
Zorg tot slot dat je niet aan één leverancier vastzit. Wat je hier mag gebruiken, wordt niet in Nederland besloten. Dat is geen theorie: in juni ging bij Anthropic binnen twee dagen het licht uit voor alle klanten, ook de Nederlandse. Weet welk lichter model je proces draaiende houdt als de sterkste wegvalt.
Volgende Stap
Een nieuw topmodel verandert weinig aan je werk. De afspraken eromheen des te meer: welke stand je draait, welk model welke taak krijgt, en wie een agent rechten geeft in je systemen. Wij rekenen dat met je door in je eigen processen, onafhankelijk van welk lab je kiest.
→ Plan een AI Strategie Sessie.
Bronnen: OpenAI, de systeemkaart van GPT-6 Astra, Artificial Analysis, NBC News, TechCrunch en The Register. Grafieken: Artificial Analysis. Headerbeeld en video: OpenAI. Volg de blog van AI Centrum Nederland om op de hoogte te blijven.
Lees ook
OpenAI brengt ChatGPT Images 2.5 uit, half zo lang wachten
Het nieuwe beeldmodel genereert tot twee keer zo snel en bewerkt preciezer. De prijs per token bleef staan op 30 dollar per miljoen.
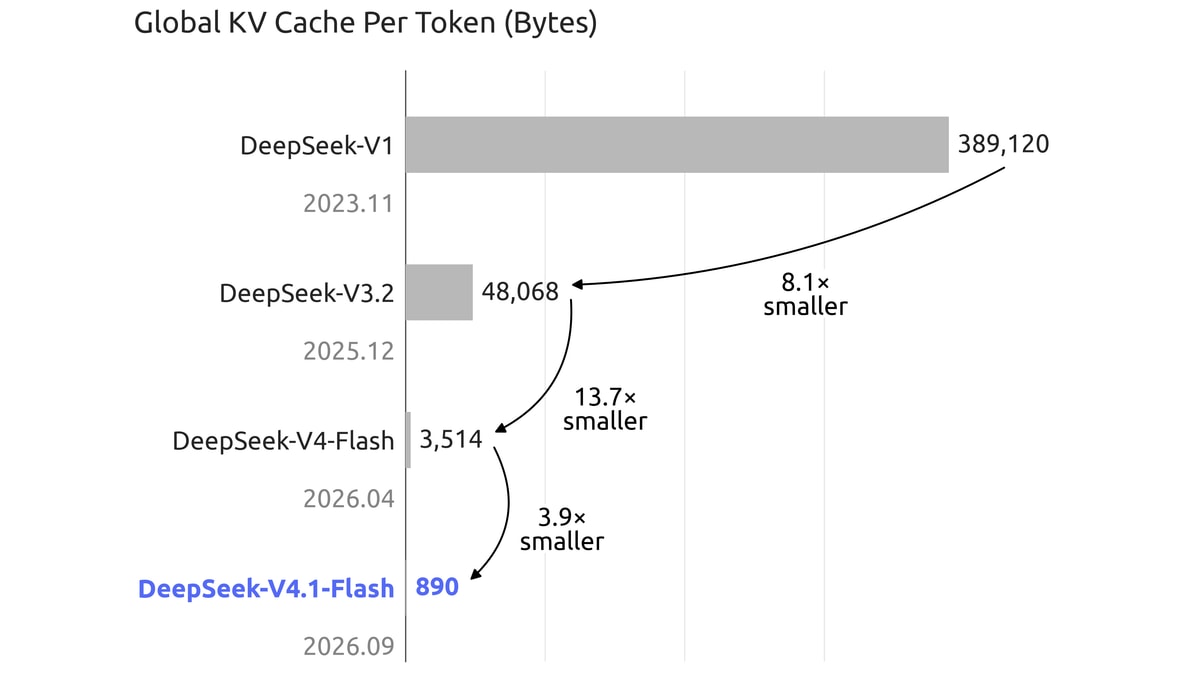
DeepSeek V4.1 Flash snijdt 75 procent uit zijn contextcache
DeepSeek V4.1 Flash gebruikt 75% minder globale KV-cache dan V4 Flash. Bekijk de bronfiguren en cijfers over geheugen, hardware en kosten van lange AI-agents.
OpenAI opent GPT-Live-1 voor eigen spraakapps
GPT-Live-1 kan tegelijk luisteren en spreken. OpenAI rekent 5 dollarcent per minuut voor de spraaklaag; het achterliggende model komt daar nog bij.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.