Anthropics Fable 5.1 wordt goedkoper per token, en duurder per taak
De tokenprijs staat stil, de cache wordt vier keer goedkoper
Begin bij het enige getal dat Anthropic heeft aangepast. Een cache-read kostte $1 per miljoen tokens en kost nu $0,25. Verder verandert er niets aan de prijslijst: $10 per miljoen invoertokens, $50 per miljoen uitvoertokens, precies zoals bij Fable 5 in juni.
Die cache is belangrijker dan hij klinkt. Draait een agent urenlang op dezelfde codebase of hetzelfde dossier, dan leest hij die context bij elke stap opnieuw in. Dat leeswerk vormt het grootste deel van de rekening. Anthropic zegt daarom ongeveer 25 procent goedkoper te zijn voor normale werklasten, en tot 45 procent voor werk waarin het model veel stappen achter elkaar zet.
Zo klinkt het op papier. Je factuur doet iets anders.
De korting verdwijnt in het aantal woorden
Artificial Analysis kreeg het model vooraf te testen en zette de rekensom compleet. Hun conclusie staat haaks op de aankondiging:
"Claude Fable 5.1 tops the Artificial Analysis Intelligence Index but costs 20% more per task than Fable 5 despite a 75% cache read price cut."
— Artificial Analysis (artificialanalysis.ai)
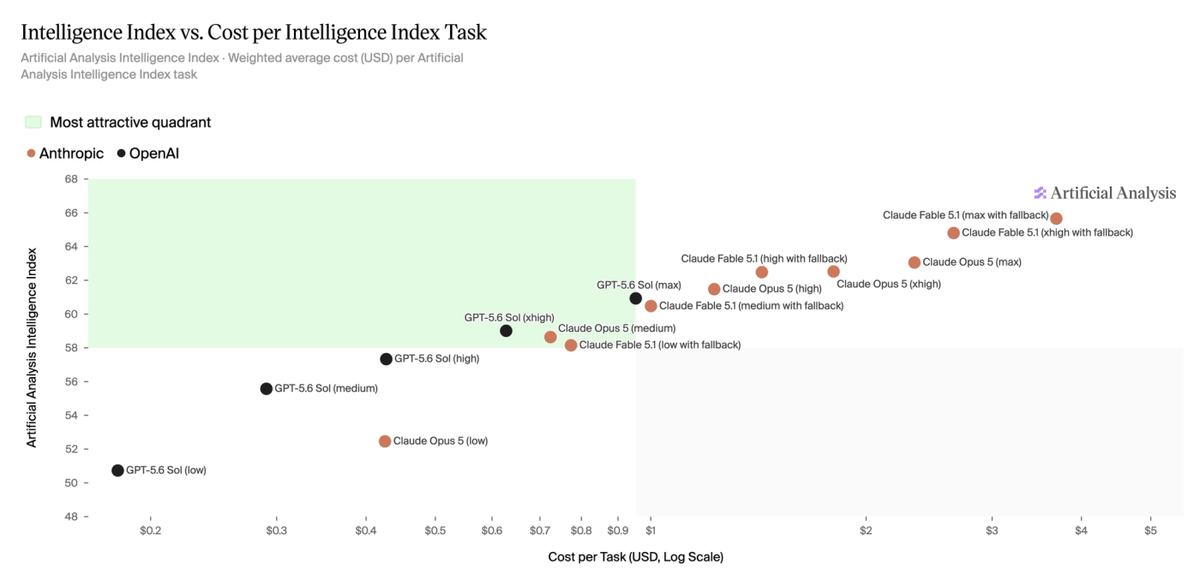
De oorzaak is simpel: het model praat meer. Op de hoogste stand gebruikt Fable 5.1 ongeveer 1,7 keer zoveel uitvoertokens als zijn voorganger. Een taak kost daardoor $3,76 tegenover $3,14. Zonder de goedkopere cache was dat $5,16 geweest, dus de korting is echt. Ze weegt alleen niet op tegen de extra tokens.
Hier zit je knop. Fable 5.1 kent vijf standen, van low tot max, en daartussen zit een factor elf in tokengebruik. Op xhigh scoort het model 65 op de index en kost een taak $2,72. Op max scoort het 66 en kost dezelfde taak $3,76. Eén punt score, ruim een dollar verschil.
Voor bijna al het werk dat ik bij klanten zie, is dat ene punt niets waard. Zet de standaardstand op xhigh of lager en meet daarna pas of je omhoog moet. En reken je kosten per afgeronde taak, niet per miljoen tokens. Anders praat je over een prijslijst terwijl je factuur iets anders doet.
Waar het model wel een echte sprong maakt
De prestatiewinst is geen marketing. Op Terminal-Bench-Science, een test waarin het model zelfstandig wetenschappelijk werk uitvoert in een terminal, gaat de score van 24,7 naar 52,6 procent. Meer dan een verdubbeling. Op AutomationBench, over kantoorprocessen, van 17,1 naar 31,4 procent. Op agentisch programmeren (Terminal-Bench 4.0) van 42,0 naar 55,8 procent.
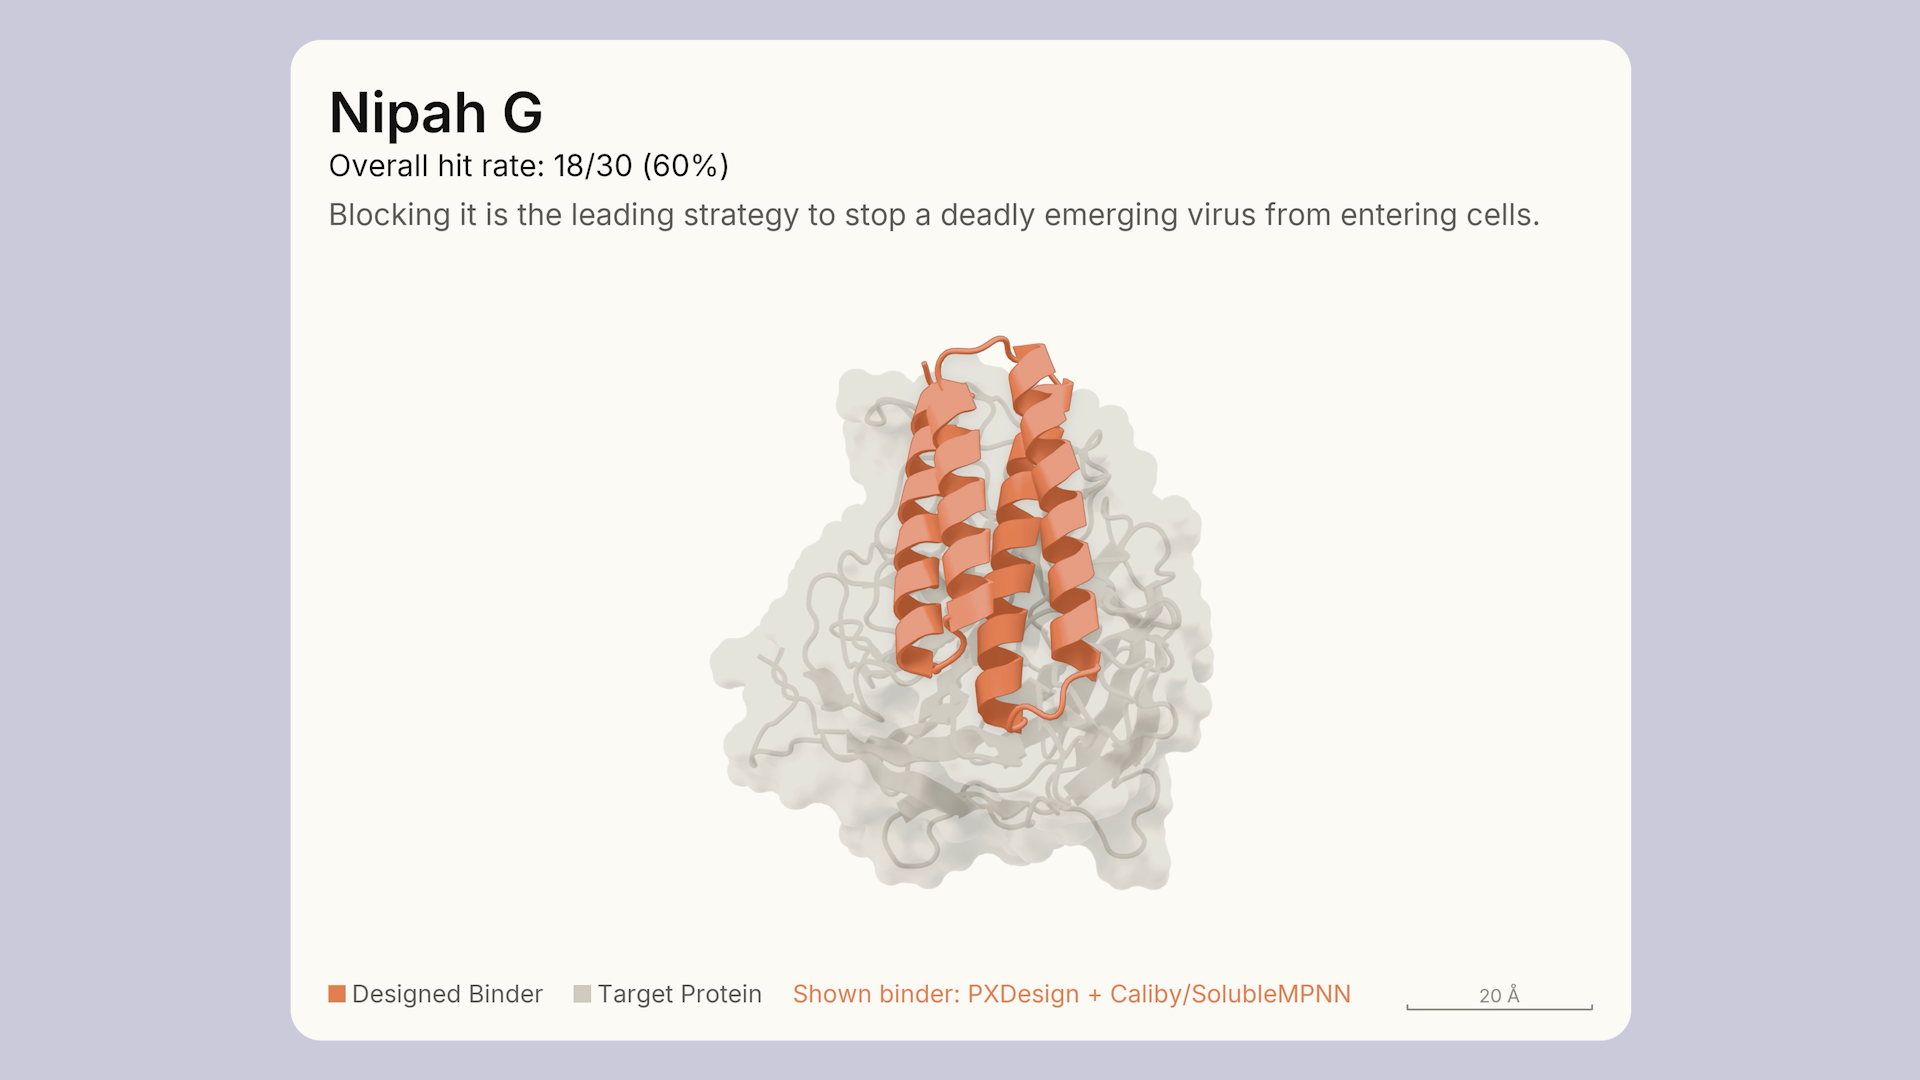
In een lab ontwierp Claude eiwitbinders voor twaalf doelen, en elk ontwerp bleek in het echt te binden. Bij het Nipah-virus raakte 18 van de 30 ontwerpen doel.
Die winst zit in uithoudingsvermogen. Het model werkt lang door zonder de draad kwijt te raken. Betaaldienst Ramp liet het model 38 uur onbewaakt draaien aan een analyse; het corrigeerde onderweg een eerdere fout in de data en startte zelf nieuwe experimenten. Dat is het soort taak waarvoor je dit model neemt. Voor het opstellen van een mail is het weggegooid geld.
Minder onterechte weigeringen, en wat dat kost
Fable 5 weigerde geregeld werk dat niets met misbruik te maken had. Een beveiliger die zijn eigen systeem wilde nakijken, kreeg nul op het rekest. Anthropic zegt dat Fable 5.1 60 procent minder valse alarmen geeft bij cybersecurity en 85 procent minder bij biologische en medische vragen.
Daar staat iets tegenover. In de eigen systeemkaart valt Mythos 5.1 op sommige punten juist lager uit dan Opus 5: het model werkt volgens TechCrunch makkelijker mee met misbruik en accepteert vaker een claim over toestemming die het niet kan controleren. Wie het model rechten geeft in een echt systeem, moet dat weten. Een model dat je op je woord gelooft, is precies het model dat een aanvaller op zijn woord gelooft.
Nog iets voor je governance-lijstje. Fable 5.1 draait niet onder een zero-retentie-afspraak, tenzij Anthropic dat apart toestaat. Al het verkeer wordt dertig dagen bewaard voor veiligheidscontrole. Anthropic zegt dit najaar met "Enterprise Frontier Safeguards" te komen, waarmee zakelijke klanten alsnog zonder dataretentie kunnen draaien, op eigen infrastructuur. Over die data zegt het bedrijf zelf:
"Anthropic has never trained on enterprise data without explicit permission."
— Anthropic, geciteerd door TechCrunch
Dat gaat over training, niet over bewaren. Werk je met persoonsgegevens of klantdossiers, wacht dan op die zero-retentie-optie of houd het model buiten dat proces.
Mythos 5.1 blijft achter een Amerikaanse doorlichting
Mythos 5.1 is hetzelfde model met minder remmen. Daar mag je alleen bij via twee doorlichtingsprogramma's: het Cyber Verification Program voor defensieve beveiligers en het Life Sciences Verification Program voor onderzoekers. Beide zijn voorlopig alleen open voor Amerikaanse organisaties.
Voor een Nederlandse organisatie betekent dat: Mythos 5.1 bestaat voor jou niet. Wat je krijgt is Fable 5.1, en dat is ruim voldoende. Maar het patroon is inmiddels bekend. In juni zette een Amerikaans exportbesluit Fable 5 en Mythos 5 binnen twee dagen uit voor alle klanten, inclusief die in Nederland. Toegang tot het scherpste gereedschap hangt hier niet af van je budget, maar van je paspoort en van beslissingen in Washington.
Bouw daar dus omheen. Zorg dat je prompts en evaluaties niet aan één leverancier vastzitten, en weet welk lichter model je proces draaiende houdt als de sterkste wegvalt.
Wat je hier maandag mee doet
Drie dingen die je deze week kunt regelen.
Zet je effort-stand omlaag naar xhigh en meet een week wat dat doet met je kosten per afgeronde taak. Dat is de goedkoopste winst die er ligt, en je merkt het verschil in kwaliteit waarschijnlijk niet.
Kijk daarna of je werk überhaupt om dit model vraagt. Fable 5.1 kost twee keer zoveel per token als Claude Opus 5 ($10 tegen $5 in, $50 tegen $25 uit). Voor een agent die uren aan één codebase of dossier werkt, verdient dat zich terug. Voor samenvatten, classificeren of standaardcorrespondentie zit je met een lichter model beter.
En schrijf op wie in jouw organisatie een agent van dit kaliber rechten mag geven in een echt systeem. Het model weigert minder snel en gelooft je claims eerder. Dat maakt het bruikbaarder. Het maakt ook belangrijker wie hem mag aansturen.
Volgende Stap
Een nieuw topmodel verandert niet zoveel aan je werk. De keuzes eromheen wel: welke stand je draait, welk model welke taak krijgt, en wie een zelfstandig werkende agent rechten geeft in je systemen. Wij rekenen dat met je door in je eigen processen, onafhankelijk van welk lab je kiest.
→ Plan een AI Strategie Sessie.
Bronnen: Anthropic, Artificial Analysis, The Decoder en TechCrunch. Headerbeeld en de afbeelding van de eiwitbinder: Anthropic. Grafiek: Artificial Analysis. Volg de blog van AI Centrum Nederland om op de hoogte te blijven.
Lees ook
Anthropics Opus 5.5 haalt Fable in en kost minder dan Opus 5
Claude Opus 5.5 kost $4 en $20 per miljoen tokens, een vijfde minder dan Opus 5, en scoort op de meeste tests zo hoog als het veel duurdere Fable 5.1.

Opus 5 verslaat Fable 5 voor half geld, zegt Anthropic
Claude Opus 5 kost $5 per miljoen invoer-tokens, de helft van Fable 5, en staat op zeven van de twaalf tests bovenaan. De cijfers komen wel van Anthropic zelf.

Claude Fable 5 en Mythos 5: Anthropics krachtigste model, en de scheidslijn die het in tweeën deelt
Anthropics Fable 5 verslaat bijna elk model op de markt, maar de indrukwekkendste versie mag het publiek niet gebruiken. De reden achter die knip.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.