OpenAI zet 722 wiskundepapers van zijn AI tegelijk online
Francis Johnson werkte 25 jaar aan één wiskundeprobleem. Hij schreef er twee boeken over en gaf het daarna op. Begin oktober stond er een oplossing online, geschreven door een AI-model van OpenAI.
"Het verbaast me niet dat het AI gelukt is, maar het verbaast me wel dat AI het zo snél voor elkaar heeft gekregen."
— Francis Johnson, wiskundige aan University College London (New Scientist)
Zijn probleem was er één van honderden. Op 6 oktober verscheen een openbare map op GitHub, de site waar programmeurs hun code delen, met 722 wiskundepapers van OpenAI erin. Samen gaan ze over 372 open problemen in 17 vakgebieden. Het model dat ze schreef, heeft OpenAI nog niet uitgebracht.
Een dag later waren er al drie ingetrokken. Ongeveer de helft van de resultaten was bij publicatie niet bevestigd, liet een woordvoerder weten aan Retraction Watch.
Vierduizend problemen erin, 722 papers eruit
OpenAI legde zijn interne model ongeveer 4000 open problemen voor. De reden staat in de map zelf. Op de bestaande wiskundetests haalde het model al zo goed als de maximale score, dus moest er iets zwaarders komen (OpenAI op GitHub). Wat het model oploste en wat OpenAI belangrijk genoeg vond, staat nu online, gebundeld in 372 families. Een familie is een hoofdresultaat met de papers die erop voortbouwen.
±4000
open problemen kreeg het model voorgelegd
722
papers gingen op 6 oktober online
42%
van de papers heeft een hoofdresultaat dat een computer naliep
3 uur
rekentijd per resultaat, gemiddeld
Bijna elk paper kwam volgens OpenAI uit één opdracht aan één AI-agent (Engadget). Bij een paar resultaten hielpen mensen wel mee, onder meer bij een zwakkere versie van de Riemann-hypothese (OpenAI op GitHub). Het model heeft nog geen publieke naam. OpenAI zegt te werken aan een verantwoorde release ervan (Fonearena).
De claims zijn groot, en de belangrijkste staan er als opgelost. Volgens het eigen overzicht bewijst het model dat het getal π zich niet beter met breuken laat benaderen dan een doorsnee irrationaal getal. Een ander paper zou een vermoeden van Paul Erdős bewijzen over rijtjes met gelijke stappen, zoals 3, 7, 11, 15. Volgens dat vermoeden bevat elke verzameling getallen die dicht genoeg is, zulke rijtjes van elke lengte. Een derde claimt een bewijs voor het Unique Games-vermoeden. Die open vraag uit de informatica gaat over hoe dicht een computer bij de beste oplossing van sommige lastige problemen kan komen (overzicht van OpenAI).
Of dat klopt, moet blijken. OpenAI schrijft zelf dat de resultaten in verschillende stadia van controle zijn, en dat er bij de ongecontroleerde fouten kunnen zitten. Bij 300 van de 719 papers in de huidige catalogus is het hoofdresultaat nagelopen in Lean, software die elke stap van een bewijs controleert (wijzigingslog). De rest moet een mens lezen.
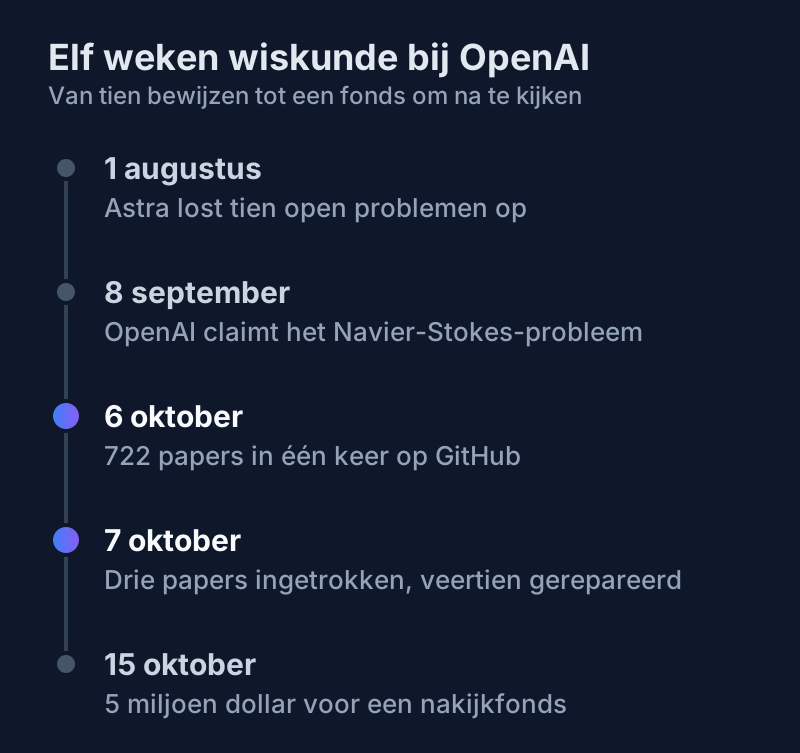
Het begon kleiner. Op 1 augustus liet OpenAI nog tien opgeloste problemen zien, van een interne versie van Astra.
Eén tekenfout kost drie papers
Alle drie draaiden om het Hodge-vermoeden, een van de zeven millenniumproblemen van de wiskunde. Op 7 oktober meldde OpenAI dat een tekenfout een redenering in één paper ongeldig maakte, en daarmee de constructie waar twee andere op leunden. Nog eens veertien papers werden gerepareerd, met verbeterde bewijzen en scherpere aannames (wijzigingslog).
OpenAI vond de fouten zelf, bij een eigen controle, en belooft volgende papers duidelijker op te schrijven. Publiceren voordat alles was nagelopen, was een bewuste keuze. De adviesgroep van wiskundigen waarmee OpenAI overlegt, had dat volgens de woordvoerder zo aangeraden (Retraction Watch).
"Given the skepticism of AI in the mathematics community, I think that OpenAI should have announced the manuscripts that were lean verified first."
— Alex Townsend, wiskundige aan Cornell University (Retraction Watch)
Het bezwaar zit in de vorm
Honderden papers tegelijk, met de controle als huiswerk voor het vakgebied: daar struikelen de meeste critici over.
Een dag na de release kwam de Association for Human Mathematics met een verklaring. Die vereniging zegt de wiskunde te beschermen tegen AI en telt 950 leden (AHM). Ze roept vakgenoten op om niet langer met OpenAI samen te werken.
"Releasing over 700 files at once is not a demonstration of scholarship, but a demonstration of power."
— Association for Human Mathematics, verklaring van 7 oktober (AHM)
Fields-medaillewinnaar Terence Tao plaatste die verklaring als gastbijdrage op zijn blog. In september tekende hij al met 24 andere winnaars van die medaille, de hoogste prijs in de wiskunde, een oproep tegen AI-bedrijven die wiskundeproblemen als benchmark gebruiken. Dat schaadt volgens hen het vak. Ruim 8300 mensen zetten er online hun naam onder (verklaring).
Ook de adviesgroep waar OpenAI mee overlegt, houdt afstand. Het gaat om negen wiskundigen, onder wie Timothy Gowers en Martin Hairer, die onafhankelijk en onbetaald werken. Eind september vroegen ze AI-labs om te stoppen met het testen van zware wiskundeproblemen op hun eigen, gesloten modellen. Wie toch resultaten publiceert, hoort volgens de groep de naam van het model en de gebruikte prompts openbaar te maken (AGMAI). In de release van OpenAI staat geen van beide (Engadget). Op 6 oktober schreef de groep dat haar adviezen geen goedkeuring zijn van de manier waarop OpenAI aan de resultaten kwam (AGMAI).
Andrew Sutherland van MIT noemt het intrekken van de drie papers "the responsible thing to do". Maar volgens hem is daarmee niet alles goed: "it will take a lot more than that to earn back the trust they have lost" (Retraction Watch).
Kevin Buzzard van Imperial College London las de dertig papers over zijn eigen vak, de getaltheorie. Zeven daarvan leken hem echt indrukwekkend. Voor de rest moeten experts alles eerst lezen en controleren, en dat kost tijd. "Journalisten zullen moeten wachten terwijl de wiskundigen hun werk doen" (New Scientist).
OpenAI betaalt nu mee aan het nakijken
Op 15 oktober kondigde de Simons Foundation, een Amerikaanse stichting die wiskundig onderzoek financiert, een fonds van 15 miljoen dollar aan. Geld en middelen komen van de stichting zelf, van OpenAI en van Anthropic. De stichting verdeelt het, onder meer via een open oproep, over workshops en projecten die onderzoekers helpen om recente AI-resultaten te beoordelen (Simons Foundation).
OpenAI legt er zelf 5 miljoen dollar in. Het geld moet wiskundigen helpen om AI-resultaten te onderzoeken en te begrijpen, "including the results we recently published", schreef het bedrijf op X (Euronews).
"This is a moment for the mathematics community to come together."
— David Spergel, president van de Simons Foundation (Simons Foundation)
Spergel voegt eraan toe dat de wiskundige gemeenschap moet bepalen hoe AI-gereedschap wordt beoordeeld en gebruikt, en niet een los bedrijf of instituut. Dat staat in de aankondiging van een fonds dat voor een deel door twee AI-bedrijven wordt betaald.
Mijn lezing: maken is goedkoop, nakijken niet
Laat ik vooropstellen: ik kan geen van deze 722 papers beoordelen. Dat hoeft ook niet om het patroon te zien. Ik kom het elke week tegen bij organisaties, alleen nu op de schaal van een heel vakgebied.
Het werk verhuist naar wie nakijkt
OpenAI betaalde de 722 papers met rekentijd. Wiskundigen betalen het nakijken met hun eigen uren, en die kun je niet bijkopen. Zo ging het bij Buzzard: dat zeven van zijn dertig papers echt iets voorstellen, kon geen model voor hem beoordelen. Daar moest hij zelf voor gaan zitten.
Bij klanten zie ik hetzelfde in het klein. Een offerte of een beleidsnotitie staat er met AI in een paar minuten. De collega die hem controleert, is er net zo lang mee bezig als vroeger. Soms langer, omdat zij de redenering niet zelf heeft opgebouwd. En leuk vindt bijna niemand het.
Wie meer laat maken dan er nagekeken kan worden, bouwt een stapel op. Wiskundigen hebben die stapel nu op hun bureau, met 722 papers erin.
Een computer die nakijkt, verandert de som
Het getal dat in deze release telt, is 300: zoveel papers hebben een hoofdresultaat dat een computer in Lean heeft nagelopen. Daar hoeft niemand OpenAI op zijn woord te geloven. Het programma keurt het bewijs goed of af. Een mens hoeft alleen nog te controleren of de stelling in Lean dezelfde is als die in het paper.
Townsend van Cornell zei het al: breng die gecontroleerde papers eerst. Ik denk dat hij gelijk heeft, en dat het verder reikt dan wiskunde.
In organisaties loopt precies dezelfde scheidslijn. Code met tests of een factuur die op de order moet passen: daar kan AI veel meer maken zonder dat de controle achterblijft. Werk dat alleen een mens kan beoordelen, groeit nooit harder dan de agenda van die mens.
Eén fout neemt de rest mee
Eén tekenfout haalde drie papers onderuit: één redenering viel om, en twee papers die erop leunden vielen mee. Met AI-werk in een bedrijf gaat het niet anders. Een samenvatting met een fout wordt de basis voor een analyse, en die analyse voor een besluit. Hoe sneller er gemaakt wordt, hoe meer er al op een fout rust voordat iemand hem ziet.
Eén ding deed OpenAI wel goed. Binnen een dag waren de papers ingetrokken, met uitleg erbij. Dat zie ik zelden bij een rapport dat al rondgaat.
Een trofee in de etalage
Het model achter de 722 papers zit niet in ChatGPT en niet in de API. Te koop is wel GPT-6 Astra, dat OpenAI begin september uitbracht.
"Wiskundige ontdekkingen worden door de bedrijven gezien als een haalbare intellectuele trofee."
— Ben Allanach, wis- en natuurkundige aan de University of Cambridge (New Scientist)
Wiskunde is daar ideaal voor. Een bewijs klopt of het klopt niet, en een probleem dat dertig jaar openstond, haalt vanzelf het nieuws. Het is ook het scorebord tussen de labs geworden. In mei weerlegde een intern model van OpenAI een vermoeden van Erdős uit 1946 (eerder hier). Anthropic meldde dagen later dat zijn Mythos-model hetzelfde probleem had gekraakt (OfficeChai).
Een etalage kun je bewonderen, niet testen. Sutherland van MIT zegt het scherp. Zolang OpenAI het model niet uitbrengt en niemand de resultaten kan herhalen, zijn claims over problemen die in één keer zijn opgelost "unverified" (Engadget).
Opvallend is wie het nakijken nu meebetaalt. Concurrent Anthropic legt geld in hetzelfde fonds van de Simons Foundation. De labs racen met hun resultaten en delen de rekening van de controle.
Voor wat een Nederlandse organisatie vandaag kan inkopen, verandert er niets. Wel is duidelijk geworden wat schaars is. Het model leverde 722 papers. Buzzard vond er zeven van dertig echt indrukwekkend. Dat getal kwam van een mens, en daar zit voorlopig de flessenhals.
Volgende Stap
Maakt jouw team met AI meer dan iemand kan nakijken? Daar helpen we organisaties mee: afspraken over wie wat controleert, en over waar een automatische check het werk kan doen. Plan een vrijblijvend gesprek.
Headerbeeld: OpenAI. Tijdlijn: AI Centrum Nederland, op basis van OpenAI, Retraction Watch en de Simons Foundation.
Lees ook
OpenAI's Astra lost tien wiskundeproblemen op voor 2000 dollar
Astra, OpenAI's volgende model, loste tien decennia-oude wiskundeproblemen op voor nog geen 2000 dollar. Eerst moet het langs een Amerikaanse overheidstoets.
Anthropic sluit interne AI-tests af van internet
Anthropic sluit al zijn interne tests af van internet nadat agents hun grenzen omzeilden. Vijf lekroutes uit de bronnen, met het hek dat elk dichtzet.
ChatGPT krijgt in de EU een onzichtbaar tekstwatermerk
OpenAI zet binnen weken een onzichtbaar watermerk in ChatGPT- en Codex-tekst in de EU. Wijzig 25 procent van de woorden en detectie zakt naar 17 procent.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.