Harness maakt coding agent tot drie keer duurder per taak
Twee onderzoekers van Shandong University zetten dezelfde taalmodellen in drie verschillende coding agents en lieten ze dezelfde programmeertaken oplossen. Hun conclusie staat in de titel: "What Does a Harness Buy? Tokens, Mostly" (arXiv, 3 oktober). Claude Code, de zwaarste van de drie, schrijft niet aantoonbaar betere code. Hij verstookt wel de meeste tokens.
Wat is een agent harness?
Een coding agent is een taalmodel met een harness eromheen. De harness is volgens de auteurs alles rond het model: de systeemprompt, de tools die het mag aanroepen, hoe hun uitkomst terugkomt en hoe een te lang gesprek wordt ingekort. Claude Code van Anthropic, het open-source OpenCode en het kale mini-SWE-agent zijn harnesses.
Een agent werkt in stappen. Bij elke stap stuurt de harness de vaste prompt plus alles wat er al gebeurde opnieuw naar het model. Die vaste prompt betaal je dus elke stap opnieuw.
Wat de onderzoekers maten
Yangze Liu en Zhongyi Han draaiden vijf modellen: twee van Qwen, DeepSeek-V4-Flash, GLM-5.3-Flash en HY4-Preview van Tencent. Claude Opus 5 draaide alleen in Claude Code, als ijkpunt. De taken zijn echte bugs uit SWE-bench Verified. Alle modellen kregen 45 moeilijke taken, de twee Qwen-modellen ook nog 447 andere. Alles liep offline: in vroege runs haalde 71 procent van de DeepSeek- en Qwen-pogingen de oplossing gewoon van GitHub.
Van harness wisselen verandert minder dan opnieuw draaien
Op de 447 taken liggen de zwaarste en de lichtste harness, Claude Code en mini-SWE-agent, binnen 5 procentpunt. Op de 45 moeilijke taken verandert een wissel van harness de uitkomst bij 13 procent van de taken. Dezelfde harness nog eens draaien doet dat in de mediaan ook bij 13 procent. Een ander model verschuift 22 procent.
"The harness does decide the bill, and it decides it in a way the pass rate hides."
— Yangze Liu en Zhongyi Han, onderzoekers aan Shandong University (paper)
Eén verschil komt boven de ruis uit, en dat is een verlies. OpenCode blijft op de grote set tot 9 punten achter. Bij één model komt de helft daarvan door uitvoer die op 32.000 tokens werd afgekapt.
Een verschil van een paar punten, zoals de 2,4 punten die GLM-maker Zhipu adverteert voor zijn harness ZCode boven Claude Code, valt binnen die ruis.
Waarom de rekening tot drie keer zo hoog wordt
Agents op OpenRouter verstoken al vijf keer meer tokens dan mensen. Wat een harness per stap meestuurt, telt dus snel op. Op GLM-5.3-Flash kost een poging (één keer een taak proberen) 1,81 yuan met Claude Code, 0,97 met mini-SWE-agent en 0,56 met OpenCode. Dat is 3,2 keer verschil, met hetzelfde model, dezelfde taken en dezelfde prijslijst. Omgerekend gaat het om ongeveer 24, 13 en 7,5 eurocent (eigen omrekening tegen de ECB-koers van 23 oktober, gecontroleerd op 25 oktober 2026). The Decoder noemt dezelfde 1,81 en 0,56 yuan.
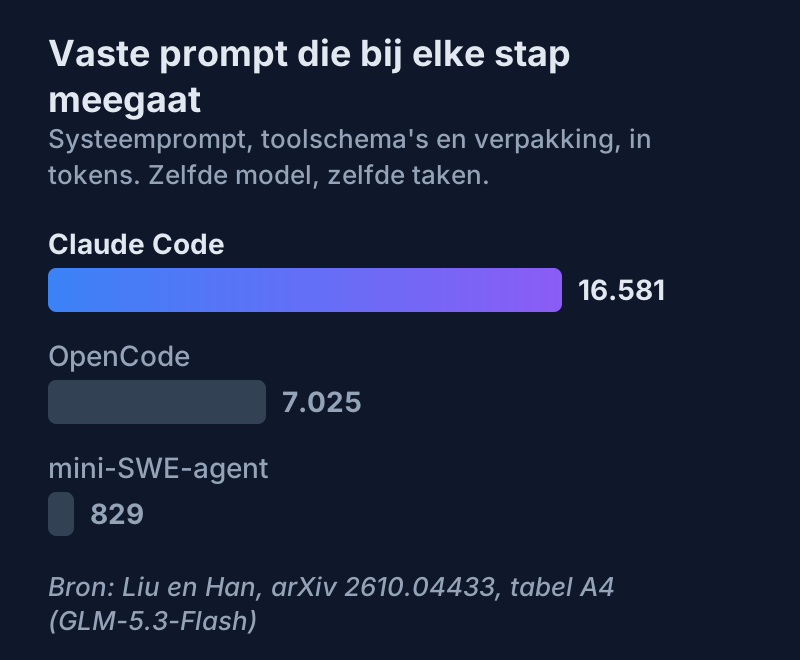
De rekening hangt volgens de paper aan drie getallen: de eerste aanroep, de groei per stap en het aantal stappen. De eerste aanroep scheelt het meest. Uit die eerste aanroep leiden de auteurs af hoeveel systeemprompt en toolbeschrijvingen elke stap meegaan: 16.581 tokens bij Claude Code, 7.025 bij OpenCode en 829 bij mini-SWE-agent. Claude Code houdt ook de redenering van het model in het transcript, dat elke stap meegaat. OpenCode is het goedkoopst omdat het minder meestuurt én het eerst stopt: na 55 stappen, tegen 80 bij mini-SWE-agent en 88 bij Claude Code. De vaste prompt is bij Claude Code ongeveer een vijfde van alle invoer (eigen berekening uit tabel A4); de rest is het transcript dat elke stap groeit.
Een wet is het niet. Op DeepSeek-V4-Flash kost Claude Code 0,98 yuan en mini-SWE-agent 1,02, omdat mini daar 141 stappen zet tegen 104. Hetzelfde patroon zagen we bij Fable 5.1: goedkoper per token, duurder per taak.
Hieronder reken je uit wat alleen de vaste prompt per taak en per maand kost, met en zonder cache. Het tweede tabblad toont de gemeten totalen op beide modellen.
Interactief
Reken uit wat de vaste prompt per taak kost
Harness, met de cijfers uit de studie
Alleen de vaste prompt, per taak
0,345 CNY
Niet de hele rekening. Gemeten per poging, alles meegeteld: Claude Code 1,81, mini-SWE-agent 0,97 en OpenCode 0,56 yuan.
- Tokens vaste prompt per taak
- 1.460.786
- Per maand, 1.000 taken
- 345,43 CNY
Met cache: eerste stap normaal tarief, daarna cachetarief.
In de studie kwam 96 tot 99 procent van alle invoer uit de cache.
Standaard de Zhipu-lijstprijs uit de studie. Vul je eigen prijs in, in je eigen munt.
Tokens vaste prompt per taak, met de stappen uit de studie
- Claude Code1.460.786
- OpenCode387.078
- mini-SWE-agent66.486
Dit is alleen de vaste prompt. In de studie is dat bij Claude Code ongeveer een vijfde van de invoer; de rest is het transcript dat bij elke stap meegroeit, plus de uitvoer van het model. Cijfers: GLM-5.3-Flash, tabel A4 en figuur A3.
Gebouwd door AI Centrum Nederland. Cijfers uit Liu en Han, arXiv 2610.04433 (preprint, 3 oktober 2026), gemeten op GLM-5.3-Flash. Een toeslag voor het wegschrijven naar de cache zit er niet in.
En caching dan?
Caching zit in de studie. Omdat elke stap het transcript opnieuw stuurt, komt 96 tot 99 procent van de invoer uit de cache. Zhipu rekent 0,8 yuan per miljoen tokens invoer en 0,23 voor een cache-hit, DeepSeek een dertigste van de normale prijs. Ook tegen de prijslijst van de andere aanbieder blijft de volgorde van de harnesses gelijk.
Waar het onderzoek ophoudt
Gesloten topmodellen draaiden alleen in Claude Code, dus of zij dezelfde kloof laten zien, weet niemand. Het is één benchmark, en de vaste prompt is uitgesplitst op één model (GLM-5.3-Flash) en één versie van Claude Code. De paper is een preprint zonder peer review; data en scripts staan wel openbaar (GitHub). Dit stuk is bronnenonderzoek, geen eigen test.
Een onafhankelijke meting wijst dezelfde kant op. HarnessTax van Arena vond dat Claude Code op SWE-bench Lite ongeveer twee keer zoveel kost als de lichte harness Pi, bij een slagingspercentage dat binnen 2 procent ligt (Arena).
Drie vragen die een leverancier moet kunnen beantwoorden
Uit de paper volgen drie vragen bij de aanschaf van een agenttool:
- Wat kost een opgeloste taak, en niet alleen een miljoen tokens?
- Hoe groot is de vaste prompt bij de eerste aanroep, en hoeveel stappen zet de agent gemiddeld?
- Hoeveel verschuift de score als dezelfde opzet twee keer draait? De auteurs willen die tweede run naast elk geclaimd verschil zien.
Volgende Stap
Wil je de kosten per taak van een coding agent vooraf op een rij? Neem contact op.
Headerbeeld: gegenereerd door AI Centrum Nederland. Grafiek: eigen weergave van cijfers uit Liu en Han (2026).
Lees ook
Experts volgen ongemerkt hun AI, ook als een muntworp koos
Analisten volgden een AI-agent in 86% van de keuzes, terwijl een muntworp zijn voorkeur bepaalde. Wat dat betekent voor menselijk toezicht onder de AI Act.
ChatGPT Pro kosten in Nederland: meer limiet en API-tegoed
ChatGPT Pro kost $100 tot $500 per maand. Sinds 29 oktober met meer gebruik en API-tegoed, dat Claude Max al had. In euro, en wanneer Business of Team past.
Gemini 4 Carbon in Nederland: een prijs, nog geen toegang
Wanneer komt Gemini 4 Carbon naar Nederland? Nog geen datum, over de EU geen woord. Wat het in euro kost en waarom Argon nu je Gemini 4 is.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.