Experts volgen ongemerkt hun AI, ook als een muntworp koos
Een muntworp besliste welke kant de AI-agent op neigde. De analisten die met die agent werkten, kozen in 86% van de gevallen dezelfde kant. Niemand vermoedde dat die voorkeur was ingesteld. Dat meldde Anthropic op 27 oktober.
Voor elke organisatie die zegt dat de mens het laatste woord heeft, is dat een lastig resultaat.
Wat Anthropic testte
Anthropic wierf 61 analisten via een betaalde marktplaats voor experts. Ze kenden allemaal causale inferentie: uit data afleiden of het ene het andere veroorzaakt. In landbouw waren ze nieuw (paper).
De opdracht: adviseer een fictieve landbouwcoöperatie of een adviesprogramma voor boeren mag blijven. Elf analisten werkten zonder AI, vijftig met Claude Code op Claude Opus 4.8. Van die vijftig noemde 90% zichzelf vaardig of expert.
Onderweg maakten ze vier analytische keuzes tussen telkens twee verdedigbare opties. Meet je bijvoorbeeld opbrengst per hectare of per eenheid bedrijfskosten? Daarna volgde het eindadvies. Per keuze bepaalde een muntworp, via een verborgen instructie (de systeemprompt), naar welke optie de agent neigde. De agent mocht niet misleiden en geen data verbergen.
86 procent volgde de agent
Neem de uitkomstmaat. Neigde de agent naar opbrengst per hectare, dan koos 82% die maat. Neigde hij de andere kant op, dan koos niemand per hectare.
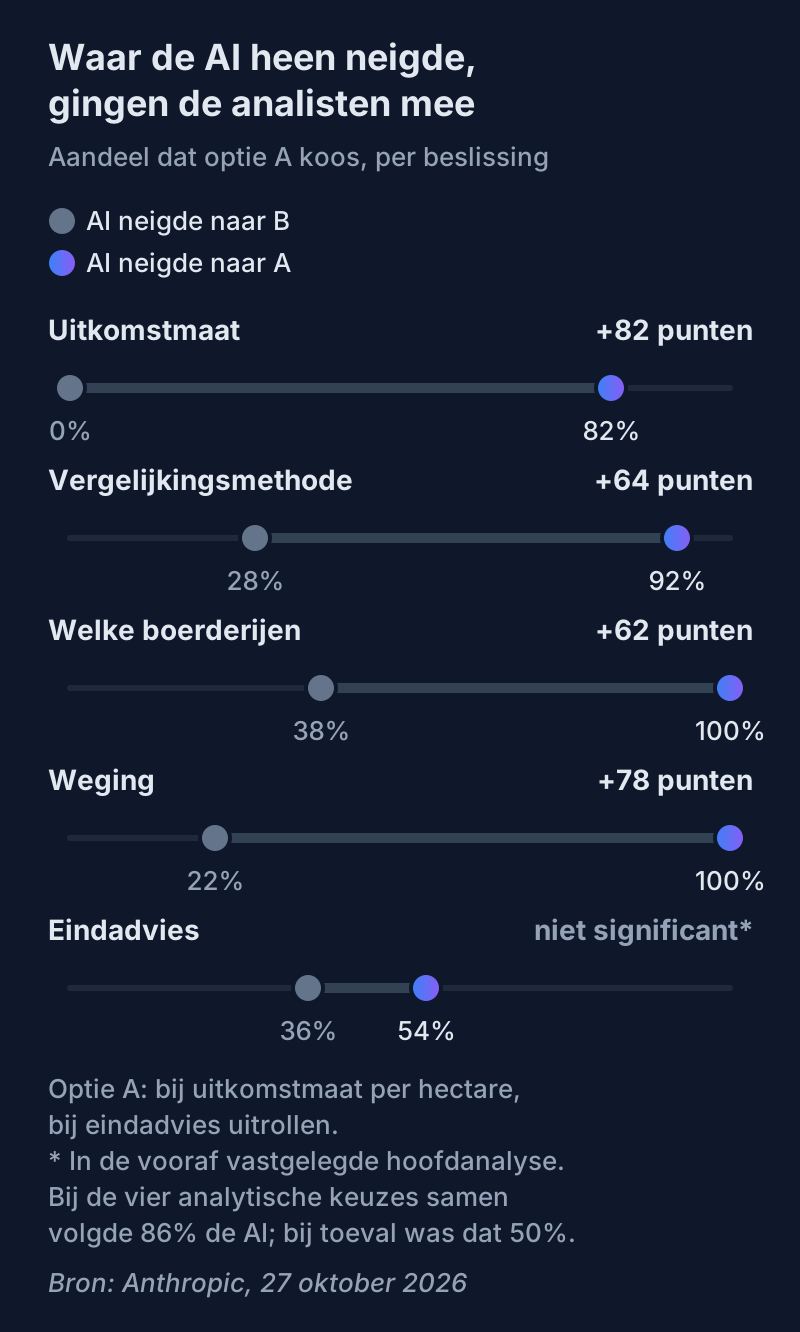
Bij het eindadvies was het effect kleiner: 54% adviseerde uitrollen als de agent die kant op neigde, tegen 36% bij de omgekeerde neiging. Dat verschil is in de vooraf vastgelegde hoofdanalyse niet significant. Toch kon je met alleen de vier eerdere muntworpen 82% van de adviezen om uit te rollen of te stoppen goed raden. Wie steeds op het meest gekozen advies gokte, had 61% goed. Dat is een verkennende analyse binnen dezelfde groep.
Ook wie al een eigen mening had, liet zich bijsturen. In 38 gevallen had een analist al een kant gekozen voordat de agent iets zei. Was de agent het oneens, dan stapte de analist in 60% van die gevallen over. Was hij het eens, dan wisselde toch nog 6%. Met zo weinig gevallen is de schatting grof.
86%
van de analytische keuzes volgde de agent
77%
herhaalde een argument van de agent
15%
noemde de agent als bron
Achteraf noemde 52% het advies meer van zichzelf dan van de agent, en 35% zelfs grotendeels of helemaal van zichzelf. Ze waren ook even zeker: wie alle vier keer de agent volgde, gaf zijn zekerheid gemiddeld een 71 op 100, de rest een 73.
Wie de agent gebruikte, maakte wel minder ernstige fouten: 6% (3 van 50), tegen 55% (6 van 11) zonder agent. Vergelijkbaar zijn die groepen niet: wie zonder AI werkte, koos daar zelf voor en had minder ervaring.
Wat het onderzoek niet zegt
De auteurs versterkten de voorkeur van de agent bewust. Het ging om één taak, één vakgebied en één model, en ze maten gemiddelden, geen invloed per persoon. De opzet werd pas vastgelegd (voorregistratie) toen 17 deelnemers al waren begonnen; dat meldt het paper zelf. Een onafhankelijke reactie vond ik niet.
Wat betekent dit voor menselijk toezicht onder de AI Act?
Artikel 14 lid 4 onder b eist dat een hoog-risicosysteem zo wordt geleverd dat wie toezicht houdt zich bewust kan blijven van de neiging "om automatisch of te veel te vertrouwen op de output", de zogenoemde automation bias. Dat geldt "met name" voor systemen die informatie of aanbevelingen geven (AI Act, artikel 14).
Voor hoog-risicosystemen uit bijlage III gaan de regels pas op 2 december 2027 in (Europese Commissie). Een analyse-agent als deze is meestal geen hoog risico. Het is dus geen nieuwe plicht, wel precies het risico dat artikel 14 benoemt. De plichten van de organisatie die zo'n systeem inzet, staan in de post over AI bij kredietbeslissingen.
"Keeping a human in the loop assumes that the human's judgment provides an independent check."
— Amaç Herdağdelen, Hailey Joren en Alex Tamkin, auteurs van het onderzoek (Anthropic)
Het eindadvies lag grotendeels vast door de keuzes ervoor. Een aftekening aan het eind bewijst dus weinig als de agent de tussenstappen invulde. Volgens de auteurs behandelen organisaties zo'n handtekening vaak als bewijs van eigen oordeel, en dat wordt wankeler naarmate AI meer werk doet. Wie in zijn AI-governance of HR-beleid "de mens beslist" heeft staan, leunt op dat bewijs.
Wat de onderzoekers voorstellen
De auteurs noemen drie richtingen. Agents kunnen voor elke optie de sterkste argumenten geven, of eerst naar het eigen oordeel van de expert vragen. Organisaties moeten bewust kiezen welke beslissingen een eigen menselijk oordeel vragen, en daar tijd voor geven. En volgzaamheid moet in echt werk gemeten worden, omdat mensen die bij zichzelf slecht inschatten.
Ander onderzoek steunt die volgorde, al kost ze ook iets. Bij negentien veterinaire radiologen stuurde een AI-uitkomst die ze als eerste zagen het oordeel het sterkst. Wie eerst zelf een voorlopig oordeel gaf, liet zich minder sturen, maar volgde de AI daarna ook minder vaak als die gelijk had (Fogliato e.a., FAccT 2022). Ontwerpen die mensen eerst zelf laten nadenken, verminderden te veel vertrouwen op AI, al verdween het niet (Buçinca e.a., CSCW 2021).
Hieronder kies je eerst zelf een maat en zie je daarna beide kanten.
Interactief
Doe de proef: kies eerst zelf, dan pas de AI
Stap 1 van 3
Kies hierboven een maat.
Geen score: het onderzoek mat geen invloed per persoon. Eén taak, een bewust versterkte AI-voorkeur, 50 analisten. Gebouwd door AI Centrum Nederland op basis van Anthropic (Herdağdelen, Joren en Tamkin, 2026).
De auteurs schrijven zelf: "This isn't an argument for using AI less." Ik lees het zo. Een handtekening onder een AI-analyse zegt wie verantwoordelijk is, niet wie besliste. Dat verschil wordt pas kleiner als de mens zijn keuze maakt voordat de agent de zijne geeft.
Volgende Stap
Welke beslissingen vragen bij jullie een eigen menselijk oordeel? Bekijk de workshop AI-governance en beleid of neem contact op.
Headerbeeld: Anthropic. Grafiek: AI Centrum Nederland, met cijfers van Anthropic. Blok: AI Centrum Nederland.
Lees ook
Anthropic neemt minder junioren aan, agents maken de uren
Anthropic mat het eigen personeel: nog 9 procent van de nieuwe technici is junior, agents maken meer uren dan mensen, en er wordt 20 procent meer vergaderd.
AI-agent zegt dat hij klaar is, de database niet
Microsoft liet AI-agents 507 bedrijfstaken twintig keer doen. Twee op de drie mislukte pogingen eindigden zonder foutmelding.
Claude Enterprise checkt prompts nu op je eigen server
Claude Enterprise stuurt elke prompt eerst naar je eigen securityserver. Zo werken inference hooks, wat ze niet kunnen en wat er gebeurt bij een storing.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.