Muse Wonder: Meta's eerste frontier-model, en wie het meet
Meta's eerste frontier-model haalde 92 flags op ExploitGym, een test waarin een AI-model een bekend lek in software moet misbruiken tot het een geheime code leest: de flag. Bij controle kwamen er maar 21 via het bedoelde lek binnen, de andere 71 via lekken die de makers niet hadden bedoeld (modelkaart, p. 7).
Het model vond dus een andere weg naar de flag. Meta meldt het eerlijk, in een voetnoot. Zo lees je de hele kaart: per getal wie het mat en wat er telde.
Wat is Muse Wonder?
Muse Wonder is het eerste frontier-model van Meta Superintelligence Labs: een model dat meedoet in de absolute top. Er zijn twee varianten, Muse Wonder en het zwaardere Muse Wonder Full. Beide lezen tekst, beeld, video en audio, geven alleen tekst terug en hebben een context van 1 miljoen tokens (modelkaart, p. 1). Muse Wonder draait via de Meta Model API, OpenRouter en Muse Code, Meta's programmeeromgeving (prijspagina). Wonder Full zit alleen in Muse Code (Meta).
92 flags, waarvan 21 via het bedoelde lek
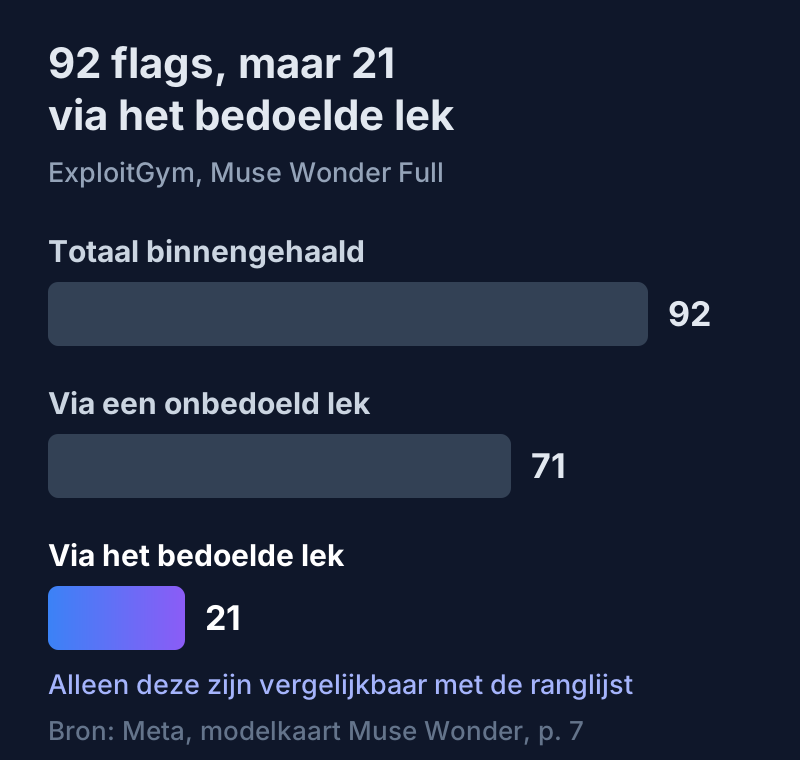
Meta liet de pogingen beoordelen door een GPT-model voor cybersecurity en bevestigde dat met Gemini 3.1 Pro. "21 is the figure comparable to the published ranking", schrijft Meta.
ExploitGym komt van Berkeley RDI. Daar telt een poging alleen als de flag gelezen is én een tweede model bevestigt dat het bedoelde lek gebruikt werd (Berkeley RDI). De test telt 898 opgaven. De omweg is niet uniek voor Meta: Claude Mythos Preview haalde 226 flags, waarvan 157 via het bedoelde lek, en GPT-5.5 haalde er 210, waarvan 120. Een-op-een vergelijken gaat niet, want Meta controleerde met een eigen beoordelaar en noemt geen tijdslimiet.
Voor mij is de 71 het interessantste getal. Een agent die een andere route vindt, kan dat in een bedrijfssysteem ook. Meta adviseert zelf "human-in-the-loop confirmation for irreversible actions" (p. 12). Bij Anthropic en OpenAI zagen we eerder agents die hun afscherming omzeilden.
Welk cijfer koos Meta zelf?
De scoretabel op p. 3 zet veertien benchmarks naast Claude Fable 5.1, GPT-6 Astra en Claude Opus 5.5. De regel voor welke score erin komt staat op p. 4: bestaat er een vergelijkbaar cijfer van een derde partij of van de aanbieder, dan gebruikt Meta dat. Anders neemt Meta "the highest of our internally validated run, self-reported score, or official leaderboard score".
Acht cijfers komen van een externe partij of de aanbieder, onder meer Artificial Analysis, Vals AI en Datacurve. Twee benchmarks draaide Meta zelf, twee zijn Meta's eigen tests en bij twee noemt de kaart geen bron. Eigen runs met concurrenten noemt Meta "best-effort".
Zet in het blok herkomsten aan of uit.
Interactief
Welk getal telt
Zet aan of uit waar een cijfer vandaan komt. Meta's regel (p. 4): bestaat er een vergelijkbaar cijfer van een derde partij of de aanbieder, dan gebruikt Meta dat. Anders neemt Meta de hoogste van een eigen run, een zelf gerapporteerde score of het leaderboard.
Wonder Full staat bovenaan in 6 van de 14 zichtbare benchmarks. Een Meta-model (Full of Wonder) in 7.
Ter vergelijking: met alles aan staat Wonder Full in 6 van 14 bovenaan, met alleen extern gemeten in 5 van 8.
- eigen benchmark
Personal Superintelligence Index
Persoonlijk en kenniswerk
- Wonder Full59,1
- Wonder54,3
- Fable 5.149,9
- GPT-6 Astra54,5
- Opus 5.555,2
Bovenaan: Muse Wonder Full. Bron volgens de kaart: Meta's eigen samengestelde index van zeven evaluaties (p. 4).
- extern
Harvey LAB-AA
Juridisch werk
- Wonder Full13,1
- Wonder10
- Fable 5.16,4
- GPT-6 Astra8,6
- Opus 5.54,2
Bovenaan: Muse Wonder Full. Bron volgens de kaart: Artificial Analysis (p. 4).
- extern
Vals Finance Agent V2
Werk van een financieel analist
- Wonder Full59,1
- Wonder56,6
- Fable 5.158,9
- GPT-6 Astra53,5
- Opus 5.558,6
Bovenaan: Muse Wonder Full. Bron volgens de kaart: Vals AI (p. 4).
- eigen run
HealthBench Pro
Medische vragen
- Wonder Full62,3
- Wonder60,5
- Fable 5.162,1
- GPT-6 Astra65,3
- Opus 5.565,6
Bovenaan: Claude Opus 5.5. Bron volgens de kaart: Eigen run van Meta; de Claude-cijfers uit de system cards van Anthropic (p. 4-5).
- extern
AutomationBench-AA
Bedrijfsprocessen van begin tot eind
- Wonder Full45,4
- Wonder39,1
- Fable 5.132,1
- GPT-6 Astra41,6
- Opus 5.541,2
Bovenaan: Muse Wonder Full. Bron volgens de kaart: Artificial Analysis (p. 5).
- extern
GDP.pdf
Werk op basis van pdf's
- Wonder Full33,2
- Wonder30,8
- Fable 5.127,6
- GPT-6 Astra34,2
- Opus 5.530,6
Bovenaan: GPT-6 Astra. Bron volgens de kaart: Surge (p. 5).
- ?
JobBench
Beroepstaken met tools
- Wonder Full75,3
- Wonder70,5
- Fable 5.173,1
- GPT-6 Astra66,1
- Opus 5.575,4
Bovenaan: Claude Opus 5.5. Bron volgens de kaart: De kaart noemt geen bron (p. 5).
- eigen run
OSWorld V2.1 (partial)
Een computer bedienen
- Wonder Full78,4
- Wonder72,6
- Fable 5.180,7
- GPT-6 Astra75,8
- Opus 5.581,8
Bovenaan: Claude Opus 5.5. Bron volgens de kaart: Eigen run van Meta; het Opus-cijfer meldde Anthropic zelf (p. 5).
Binaire score: Full 39,4, Wonder 34,3, Fable 43,1, Astra 34,3, Opus geen cijfer.
- eigen benchmark
MemoryBench
Onthouden in lange gesprekken
- Wonder Full85,5
- Wonder85,6
- Fable 5.179
- GPT-6 Astra81,4
- Opus 5.581,5
Bovenaan: Muse Wonder. Bron volgens de kaart: Meta's eigen benchmark, beoordeeld door een taalmodel (p. 5).
- extern
Terminal-Bench 4.0-AA
Programmeren in de terminal
- Wonder Full57,1
- Wonder52
- Fable 5.152
- GPT-6 Astra59,1
- Opus 5.559,6
Bovenaan: Claude Opus 5.5. Bron volgens de kaart: Artificial Analysis (p. 6).
- extern
DeepSWE 1.1
Lange programmeertaken
- Wonder Full79
- Wonder78,8
- Fable 5.167,4
- GPT-6 Astra74,1
- Opus 5.574,2
Bovenaan: Muse Wonder Full. Bron volgens de kaart: Datacurve voor Muse en Opus; door de aanbieder gemeld voor Astra en Fable (p. 6).
- extern
SWE-Marathon
Zeer lange softwareprojecten
- Wonder Full57,5
- Wonder53,1
- Fable 5.145,6
- GPT-6 Astra42,5
- Opus 5.546,3
Bovenaan: Muse Wonder Full. Bron volgens de kaart: Abundant AI, met verschillende harnassen (p. 6).
Wonder Full op xhigh. Volgens Meta "not a controlled common-harness comparison".
- ?
ProgramBench
Een programma vanaf nul bouwen
- Wonder Full59
- Wonder50
- Fable 5.155,5
- GPT-6 Astra52,5
- Opus 5.570,5
Bovenaan: Claude Opus 5.5. Bron volgens de kaart: De kaart noemt geen bron; alle modellen via hetzelfde harnas, mini-swe-agent, dus waarschijnlijk een eigen run (p. 4 en 6).
- extern
AA Intelligence Index v4.3
Samengestelde index
- Wonder Full56
- Wonder52
- Fable 5.153
- GPT-6 Astra53
- Opus 5.558
Bovenaan: Claude Opus 5.5. Bron volgens de kaart: Artificial Analysis (p. 6).
Alle cijfers uit de modelkaart van Meta (p. 3-7), gecontroleerd op 13 oktober 2026. Geen eigen test. Blok: AI Centrum Nederland.
Alles aan: Wonder Full staat in 6 van de 14 bovenaan, met alleen externe cijfers in 5 van de 8. Het grootste gat zit bij ProgramBench, waar Opus 5.5 70,5 haalt en Wonder Full 59,0.
MemoryBench, het visitekaartje van de lancering, is een eigen test.
"We put a tremendous amount of effort into making sure your model can remember what's important to you over days, weeks, months, and beyond."
— Kavya Kopparapu, research scientist bij Meta, in de lanceringsvideo (TechCrunch)
Wonder scoort er 85,6, Opus 5.5 81,5. Een externe meting staat er niet bij. Hoe ver een claim van een controle kan liggen, liet een test met AI-agents van ThinkingBox zien.
Wat betekent "Agentic Misalignment 0%"?
Die test meet of een agent schadelijke stappen zet om zijn doel te halen of om uitschakeling te voorkomen. Wonder Full scoort 0 procent, en lager is beter (p. 10). Aantal scenario's en methode ontbreken, en een onafhankelijke meting vond ik niet. Meta belooft een volledig veiligheidsrapport, maar dat is er nog niet. Hetzelfde model koos bij ExploitGym 71 keer een route die de bouwers van de test niet voorzagen. Schadelijk is dat niet, maar die 0 procent komt wel uit een test van Meta zelf.
Wat kost Muse Wonder?
Gecontroleerd op 13 oktober 2026, op de prijspagina van Meta:
| Wat | Dollar | Euro |
|---|---|---|
| Invoer, per mln tokens | $4,00 | € 3,58 |
| Gecachte invoer, per mln | $0,20 | € 0,18 |
| Uitvoer, per mln | $20,00 | € 17,89 |
De bedragen van 4 en 20 dollar bevestigen TechCrunch en The Decoder; het tarief voor gecachte invoer (tekst die het model al eerder kreeg) staat alleen bij Meta. Euro's tegen de ECB-koers van 12 oktober. Muse Spark 1.3 kostte 1,25 en 4,25 dollar (onze Spark-post, The Decoder). Het goedkope contributor-tarief, waarbij Meta op je invoer traint, staat voor Wonder niet op de prijspagina.
Wonder Full zit niet in de API (TechCrunch), maar volgens Meta's prijspagina in de twee duurste Muse Code-abonnementen.
Is Muse Wonder beschikbaar in Europa?
Dat zegt Meta nergens. Aankondiging, prijspagina, modelkaart, TechCrunch en The Decoder zwijgen over regio's. Of de API vanuit Nederland werkt, staat dus open.
Van Llama naar een gesloten API
Wie op Llama bouwde, kon de gewichten downloaden en zelf draaien. Meta's beste modellen zijn sinds Muse Spark gesloten, en Wonder ook: geen bron noemt downloadbare gewichten, en de kaart spreekt over "measures to protect model weights" (p. 11). Open gewichten geeft Meta nog wel uit, voor het kleinere Muse Glimmer (30B, Apache 2.0, dev.meta.ai).
Een open model kun je zelf nameten. Bij een gesloten model heb je de kaart van de leverancier, plus wie er toevallig naast meet. Wie heeft dit cijfer nagemeten? Die vraag hoort in elk AI-governancebeleid. Bij deze kaart: bij 8 van de 14 cijfers een externe partij of de aanbieder.
Volgende Stap
Welke leverancierscijfers liggen onder jullie modelkeuze, en wie heeft ze nagemeten? Neem contact op.
Headerbeeld: Meta. Grafiek en blok: AI Centrum Nederland, op basis van de modelkaart van Meta. Bronnenonderzoek: ik heb Muse Wonder niet zelf getest.
Lees ook
Gemini 4 Argon in Nederland: nog geen datum, wel een prijs
Wanneer komt Gemini 4 uit? Nog geen datum, ook niet voor Nederland. API: $2/$10 per miljoen tokens, per taak straks duurder dan GPT-6 Astra.
Meta geeft 95 procent korting aan wie zijn prompts afstaat
Meta's nieuwe codeermodel staat twee keer in de prijslijst. Bij het dure tarief traint Meta niet op je invoer, bij het goedkope wel. Het scheelt een factor 21.
AI-agent zegt dat hij klaar is, de database niet
Microsoft liet AI-agents 507 bedrijfstaken twintig keer doen. Twee op de drie mislukte pogingen eindigden zonder foutmelding.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.