Claude Fable 5.2: prijs, tests en wat het model zelf bouwde
$8 / $40
per miljoen tokens in en uit
49,1%
op FrontierCode 2.0
30 uur
voor een bewijs dat eerder 11 dagen kostte
Wat Claude Fable 5.2 is en wat het kost
Fable 5.2 volgt Fable 5.1 van september op als duurste model van Anthropic. De prijslijst, gecontroleerd op 9 november 2026:
- Fable 5.2: $8 per miljoen invoertokens, $40 per miljoen uitvoertokens (Anthropic). Volgens CNBC is dat 20 procent minder dan de vorige generatie.
- Fable 5.2 in de snelle stand: $16 en $80. Het model schrijft dan tot 2,5 keer zo snel.
- Fable 5.1: $10 en $50.
- Opus 5.5: $4 en $20.
Ook zonder snelle stand schrijft het model volgens Anthropic tot 30 procent sneller dan 5.1. Het leest een miljoen tokens tegelijk en schrijft er maximaal 128.000 terug. Anthropic levert het in de abonnementen Pro, Max, Team en Enterprise, in de API als claude-fable-5-2 en via Amazon Web Services, Google Cloud en Microsoft Azure.
Fable blijft twee keer zo duur als Opus 5.5. Anthropic wijst de meeste gebruikers zelf naar dat goedkopere model:
"For most coding and knowledge tasks, we recommend starting with Opus 5.5."
— Anthropic, toelichting bij de introductievideo (YouTube)
Hoe Fable 5.2 zich verhoudt tot de modellen van OpenAI, Google en Mistral staat in ons overzicht van het nieuwste AI-model per merk.
Eén ding vooraf over de maker van dit bericht. Fable 5.2 schreef het zelf en bouwde ook de twee blokken op deze pagina, in opdracht van AI Centrum Nederland. Een onafhankelijke test is het dus niet. Elk getal komt uit een bron, en de meeste bronnen heten Anthropic.
De tests, de tijdrace, de standen en een kostencalculator staan hieronder in één blok. Daarna volgen dezelfde cijfers in tekst.
Interactief
Speel zelf met de cijfers van Claude Fable 5.2
Lastige programmeertaken, zelfstandig uitgevoerd.
4 van 6
van deze tests wint Fable 5.2
Fable 5.2
scoort het hoogst op FrontierCode 2.0
Cijfers van Anthropic zelf, niet onafhankelijk nagemeten. "n.b." betekent: niet gepubliceerd.
Dit blok is ontworpen en gebouwd door Claude Fable 5.2, in dezelfde sessie als de tekst eromheen.
Waar Fable 5.2 wint, en waar niet
Zes tests uit de tabel van Anthropic, elk model op zijn hoogste stand tenzij anders vermeld:
- FrontierCode 2.0 (lastige programmeertaken): Fable 5.2 haalt 49,1 procent. Fable 5.1: 32,4. Opus 5.5: 45,5. GPT-6 Astra: 42,8. Gemini 4 Carbon: 41,1, op een middelste stand.
- Remote Labor Index (freelance-opdrachten afmaken): 41,3 procent. Fable 5.1: 17,9. Opus 5.5: 21,3. GPT-6 Astra: 20,8.
- AutomationBench (kantoorprocessen): 51,4 procent. Fable 5.1: 31,4. Opus 5.5: 42,5. GPT-6 Astra: 41,4. Gemini 4 Carbon wint met 53,9.
- Chartography (grafieken lezen): 73,4 procent. Fable 5.1: 44,8. Opus 5.5: 64,4. GPT-6 Astra: 71,0. Gemini 4 Carbon: 72,5.
- Humanity's Last Exam (alle vakgebieden, met hulpmiddelen): 74,2 procent. Fable 5.1: 65,6. Opus 5.5: 67,7. GPT-6 Astra: 57,2.
- AA-Briefcase (kenniswerk, als Elo-score): 1785. Fable 5.1: 1669. GPT-6 Astra: 1569. Gemini 4 Carbon: 1611. Opus 5.5 wint met 1800.
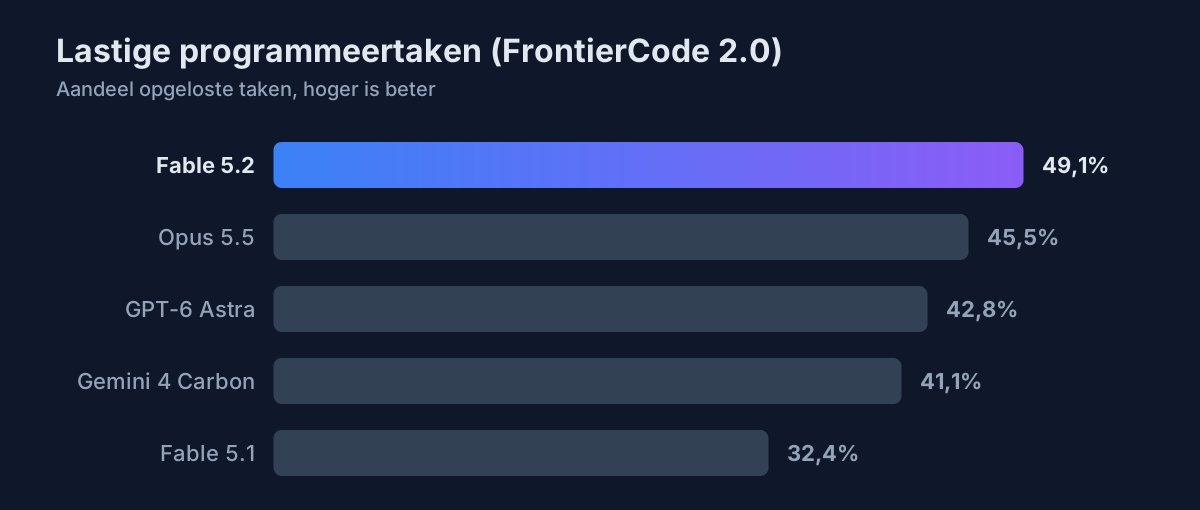
Vier keer winst, twee keer verlies. De sprong zit in het zelfstandige werk: op de Remote Labor Index gaat de score van 17,9 naar 41,3 procent.
Hier keurt de slager wel zijn eigen vlees. De externe partijen die het model vooraf testten, hebben de aankondiging niet nagelezen. Volgens Anthropics eigen voetnoot zijn ze het niet per se met de claims eens.
Eén onafhankelijke meting is er al. Vals AI zet Fable 5.2 op plek 1 van 36 in zijn index, met 71,31 procent. Het gat is klein: Claude Sonnet 5.5 haalt 70,85 en Gemini 4 Carbon 70,45. Eén test kostte daar $17,94. En op de juridische index van Vals staat het model 20e van 37. Het duurste model is niet overal het beste.
Dertig uur voor Fermat, acht dagen voor een besturingssysteem
De opvallendste claims gaan over uithoudingsvermogen. Anthropic liet 1.000 agents van Fable 5.2 het bewijs van de laatste stelling van Fermat uitschrijven in een vorm die een computer stap voor stap kan controleren. Een eerdere onderzoeksversie van Claude deed daar 11 dagen over. Het team van Fable 5.2 was na 30 uur klaar, met een derde van de actietokens en een bewijs dat zeven keer korter is. Opus 5.5 kwam met dezelfde opzet in 18 uur tot 26 procent en schoot daarna nauwelijks meer op (Anthropic).
Het tweede experiment: één ingenieur gaf een vroege versie van het model een lege map. Acht dagen later stond er een besturingssysteem dat opstart op een laptop, met eigen drivers, bestandsopslag, vensters en een inlogscherm. Ruim 1.000 subagents schreven, testten en controleerden de code.
Dezelfde feiten staan hieronder in vijf beelden, getekend met stippen die het model zelf programmeerde. De knoppen eronder kiezen een beeld.
3D-animatie
Fable 5.2 in vijf beelden
5.2
Claude Fable 5.2 kwam uit op 9 november 2026.
Vereenvoudigde weergave: de vormen zijn een illustratie, de getallen komen van Anthropic. Geprogrammeerd door Claude Fable 5.2, zonder video of plaatjes: elke stip wordt in je browser berekend.
Anthropic zette beide proeven zelf op en voerde ze zelf uit. Wat 1.000 agents acht dagen lang aan tokens kosten, staat er niet bij.
Een stand lager kost de helft
Fable 5.2 kent vijf standen, van low tot max. Hoe hoger de stand, hoe langer het model nadenkt en hoe meer tokens het schrijft. Anthropic geeft vier vergelijkingen met Opus 5.5 op zijn hoogste stand:
- Op FrontierCode 2.0 haalt Fable 5.2 op
high45,3 procent tegen 45,5, voor ongeveer de helft van de kosten per taak. - Op WANDR, een test voor zoekwerk, evenaart het op
mediumde topscore van Opus 5.5 voor ongeveer 40 procent van de kosten. - Op Chartography haalt het op
medium66,4 procent tegen 64,4, voor minder dan een tiende. - Op Humanity's Last Exam evenaart het op
lowde topscore, ook voor minder dan een tiende.
Bij Fable 5.1 beloofde Anthropic ook lagere kosten. Artificial Analysis mat daarna 20 procent hogere kosten per taak. Voor 5.2 had die partij op 9 november nog geen meting gepubliceerd die wij konden vinden.
Minder onterechte blokkades, dertig dagen bewaard
De filters voor cybersecurity en biologie blokkeren volgens Anthropic ongeveer 55 procent minder vaak dan bij Fable 5.1: 60 procent minder bij beveiligingsvragen, 40 procent minder bij biologie. Grijpt een filter toch in, dan antwoordt het oudere Opus 4.8 of Opus 5.
Anthropic houdt het verkeer dertig dagen vast voor veiligheidscontrole. De variant die niets opslaat, Enterprise Frontier Safeguards, zit in een besloten proef met Bridgewater, Salesforce en Stripe.
Mythos 5.2 is hetzelfde model zonder een deel van de filters, alleen voor doorgelichte organisaties. Anthropic beoordeelt elke aanvraag samen met de Amerikaanse overheid en noemt geen lijst van landen.
Een release vlak voor de beursgang
Volgens CNBC kan Anthropic volgende week al naar de beurs. De release komt ook kort na de oproep van het bedrijf om het tempo van de sterkste modellen te drukken. Dianne Penn van Anthropic daarover:
"We called for pacing, not pausing."
— Dianne Penn, hoofd productmanagement onderzoek bij Anthropic (CNBC)
Fable 5.2 is volgens Penn bedoeld voor de zwaarste gebruikers en het zwaarste werk.
Volgende Stap
Welk model welke taak krijgt, op welke stand, en wie een agent die dagen doorwerkt rechten geeft in je systemen: dat bepaalt je rekening en je risico meer dan de modelnaam. Wij rekenen het met je door in je eigen processen, onafhankelijk van welk lab je kiest.
→ Plan een AI Strategie Sessie.
Bronnen: Anthropic, CNBC en Vals AI. Headerbeeld en video: Anthropic. Grafiek: eigen weergave van cijfers van Anthropic. Tekst, interactief blok en 3D-animatie: Claude Fable 5.2, in opdracht van AI Centrum Nederland.
Lees ook
Anthropics Opus 5.5 haalt Fable in en kost minder dan Opus 5
Claude Opus 5.5 kost $4 en $20 per miljoen tokens, een vijfde minder dan Opus 5, en scoort op de meeste tests zo hoog als het veel duurdere Fable 5.1.

Opus 5 verslaat Fable 5 voor half geld, zegt Anthropic
Claude Opus 5 kost $5 per miljoen invoer-tokens, de helft van Fable 5, en staat op zeven van de twaalf tests bovenaan. De cijfers komen wel van Anthropic zelf.

Anthropic knijpt de Claude-limieten: Pro-gebruikers gaan per token betalen
Vanaf 20 juli halveert Anthropic de Fable 5-limieten in Max en Team, en Pro-gebruikers vallen terug op API-prijzen. Reken je Claude-verbruik opnieuw door.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-scan in 3 minuten en krijg een kansenkaart: twee kansen in uren per week, met een plan voor 90 dagen.