Meta schrapt training uit voorwaarden, robots.txt blijft je knop
Wil je niet dat Meta je website gebruikt om AI te trainen? Zet dan twee regels in robots.txt, het tekstbestand op jouwdomein.nl/robots.txt dat bots vertelt wat ze mogen lezen: User-agent: meta-externalagent en daaronder Disallow: / (Meta). Meer hoeft niet. Wat je niet verbiedt, mag een crawler al, dus vermeldingen in Meta AI en linkvoorvertoningen blijven werken. Het kan tot 24 uur duren voor de regel werkt, zegt Meta.
Vijf Meta-crawlers: wat ze doen en wat blokkeren kost
Meta stuurt vijf crawlers op het web: bots die websites lezen, elk met een eigen naam en doel.
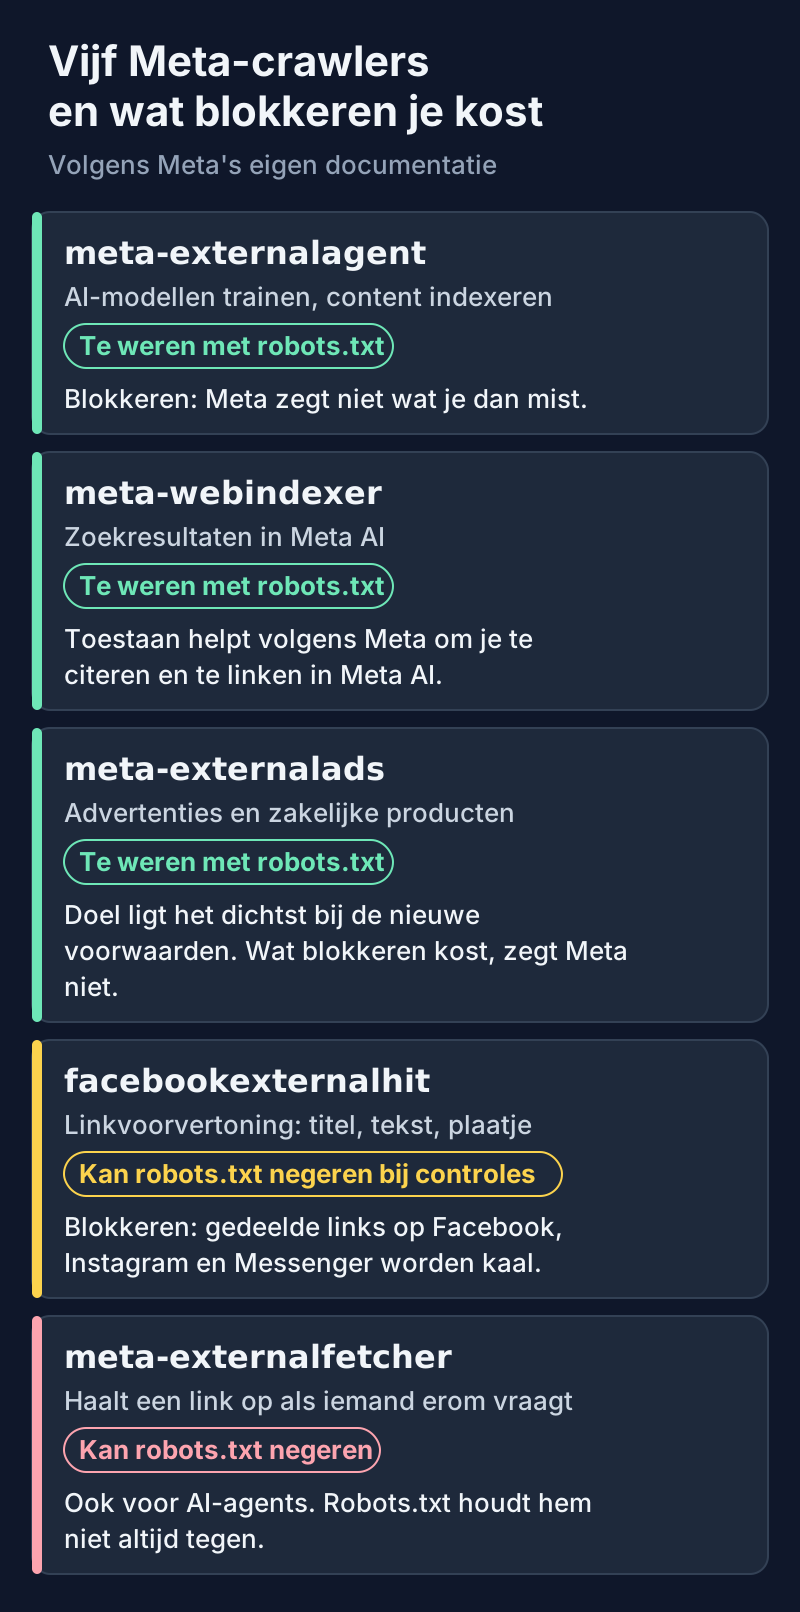
Vermeldingen in Meta AI koppelt Meta aan meta-webindexer: "Allowing Meta-WebIndexer in your robots.txt file helps us cite and link to your content in Meta AI's responses." Wat je mist als je meta-externalagent blokkeert, zegt Meta niet.
Welke crawler Meta onder de nieuwe voorwaarden inzet, staat er niet in. Het doel van meta-externalads komt het dichtst bij wat er nu staat.
De meta-externalagent robots.txt-regel om te kopiëren
Dit weert AI-training. De andere Meta-crawlers houden toegang:
# Geen AI-training door Meta
User-agent: meta-externalagent
Disallow: /
Zet ze onder de bestaande regels; vervang het bestand niet. Beheert een webbouwer of hostingpartij je site, vraag dan of die ze toevoegt.
Elk domein en subdomein heeft een eigen robots.txt. Let op één valkuil uit de standaard: een crawler met een eigen groep negeert de groep User-agent: * (RFC 9309). Wat daar staat, geldt dus niet meer voor hem.
In het blok hieronder kies je per crawler, kopieer je de regels en plak je je huidige robots.txt om te zien wat Meta er nu uit leest.
Interactief
Kies welke Meta-crawlers je toelaat en controleer je robots.txt
Begin met een snelkeuze of zet per crawler zelf aan of uit.
meta-externalagent
AI-modellen trainen en content indexeren
meta-webindexer
Zoekresultaten in Meta AI
meta-externalads
Advertenties en zakelijke producten
facebookexternalhit
Linkvoorvertoning: titel, tekst en plaatje
Kan robots.txt negeren bij controles- Niet te kiezen
meta-externalfetcher
Haalt een link op als een gebruiker erom vraagt, ook voor AI-agents
Kan robots.txt negeren
robots.txt
User-agent: meta-externalagent
Disallow: /
Plak dit onder de bestaande regels in robots.txt; vervang het bestand niet. Volgens Meta kan het tot 24 uur duren voor een wijziging werkt.
Toegestaan betekent: geen eigen regel. Zet een groep voor User-agent: * de hele site dicht, dan geldt die nog steeds. Controleer dat in het tabblad Controleren.
Wat je hiermee verliest
- meta-externalagent Meta zegt niet wat je mist als je hem blokkeert.
Wat dit niet tegenhoudt
- meta-externalfetcher: haalt links op "at a user’s request"; robots.txt houdt hem niet altijd tegen.
Samengesteld door AI Centrum Nederland uit Meta’s crawlerdocumentatie, de preview van de voorwaarden en RFC 9309. Stand 18 oktober 2026. Geen juridisch advies.
Negeert meta-externalagent robots.txt?
Meta zegt van niet. Een onafhankelijke meting die dat bevestigt of weerlegt, vond ik niet. Wie zeker wil zijn, zoekt in de serverlogs, het logboek van je webserver, op meta-externalagent/1.1 en kijkt na een dag of het verkeer stopt.
Twee crawlers mogen het volgens Meta zelf negeren. Meta-externalfetcher haalt links op "at a user's request" en "may bypass robots.txt". Facebookexternalhit kan het negeren bij veiligheids- en integriteitscontroles. De standaard zegt het ook: "These rules are not a form of access authorization." Harder weren kan alleen op de server zelf, met een filter op user-agent.
Sites weren ook de agents van Meta
Delta en JPMorgan Chase blokkeren AI-agents, programma's die namens een gebruiker een site bezoeken (The Verge). Amazon weert Meta's winkelagent Muse, met een beroep op zijn voorwaarden. Meta schreef op 6 oktober: "Turning away a personal agent means turning away the customer behind it" (Meta).
Het crawlrecht blijft, alleen het doel is smaller
Wie Facebook of Instagram zakelijk gebruikt, met een bedrijfspagina, productcatalogus of advertenties, valt vanaf 30 oktober onder nieuwe Commercial Terms. Daarin staat een crawlrecht op elk domein dat bij je producten of diensten hoort, inclusief "test credentials": testaccounts om in te loggen.
In de eerste versie stond in dat rijtje doelen ook "train". Juristen lazen daar AI-training in (Ars Technica). Uiterlijk 17 oktober was het woord weg.
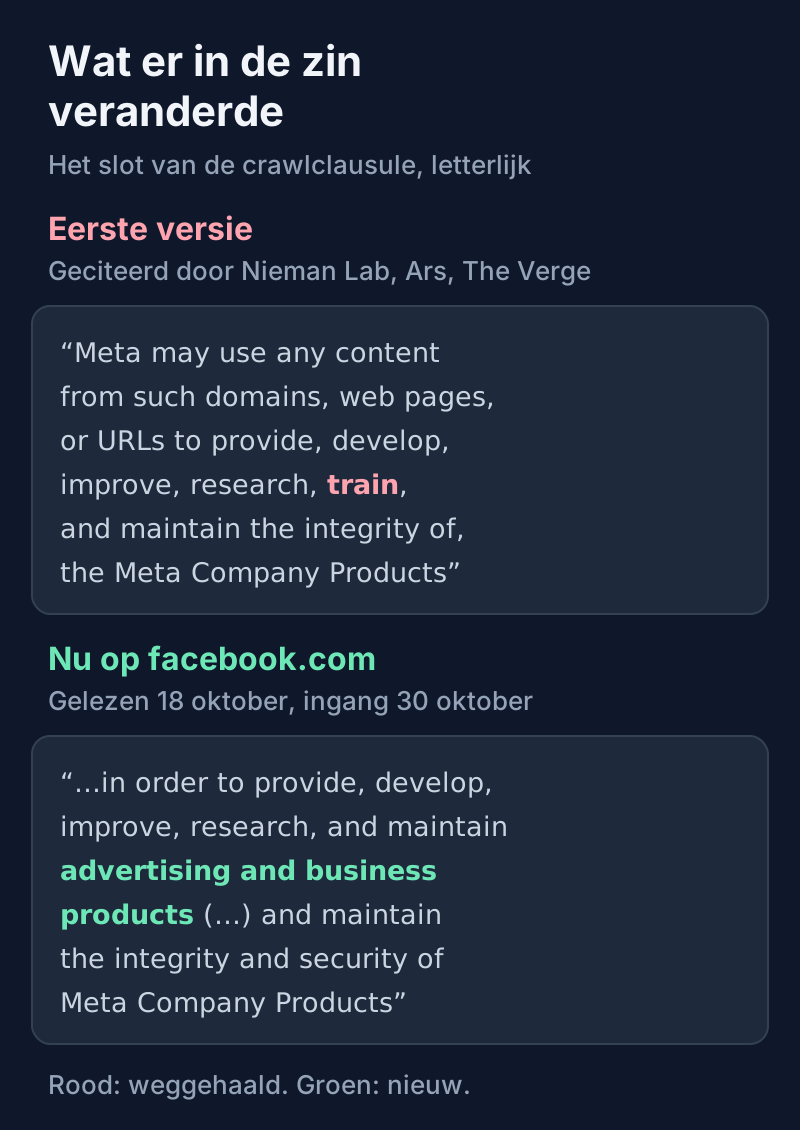
"We've heard you and want to clarify: the crawling terms we consolidated only applied to our ads and business products, and we've clarified that in the terms themselves. It does not change how Meta uses web crawlers. As always, content owners can use robots.txt to signal their preferences."
— Daniel Roberts, woordvoerder van Meta, tegen The Verge (The Verge)
Robots.txt staat nog steeds niet in het contract. Meta belooft het alleen in verklaringen en op zijn crawlerpagina. Juristen tegen Nieman Lab: training staat er niet meer in, maar is ook niet uitgesloten (Nieman Lab).
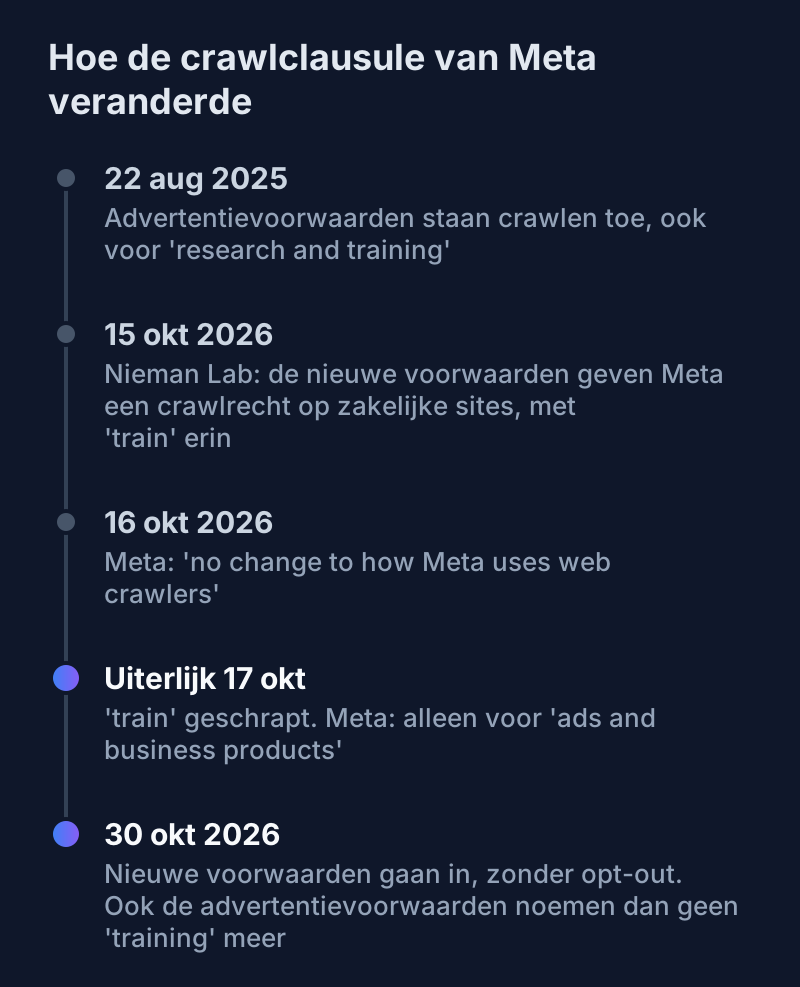
Voor adverteerders wordt de tekst nauwer. Hun huidige voorwaarden staan crawlen sinds 22 augustus 2025 toe voor "research and training" (Self-Serve Ad Terms). In de nieuwe versie per 30 oktober staat "training" niet meer.
Een opt-out ontbreekt. In de voorwaarden staat: "If you do not agree to the updated terms, you may stop all access or use of our Products for business or commercial purposes" (Commercial Terms, preview). De European Publishers Council wil dat de Europese Commissie de voorwaarden met spoed bekijkt (MLex).
Veelgestelde vragen
Verdwijn ik uit Meta AI als ik meta-externalagent blokkeer?
Meta zegt het niet. Citeren en linken hangt volgens Meta aan meta-webindexer. Of Meta AI in Nederland al met weblinks antwoordt, kon ik niet vaststellen.
Traint Meta nu wel of niet op mijn site?
De voorwaarden noemen training niet meer. De crawlerpagina noemt het wel, bij meta-externalagent. Volgens Meta verandert de nieuwe tekst niets aan hoe het crawlt.
Kan ik me afmelden zonder robots.txt?
Nee. Meta kiest robots.txt "rather than non-standard formats like NoAI tags": labels in de pagina zelf. Wie niet akkoord gaat, kan alleen stoppen met zakelijk gebruik.
Speelt de AVG ook mee?
Ja, zodra er persoonsgegevens op de site staan. Over AI-training op persoonsgegevens wordt in Europa nog onderhandeld.
Volgende Stap
Welke AI-bots en -diensten zitten aan jullie site en data? De AI-scan en de AI-governance checklist geven overzicht. Liever samen kijken? Neem contact op.
Headerbeeld: gegenereerd door AI Centrum Nederland. Tijdlijn, crawlerkaart, tekstfiguur en blok: AI Centrum Nederland, op basis van Meta, Nieman Lab, Ars Technica en The Verge. Bronnenonderzoek, geen eigen test. Geen juridisch advies.
Lees ook
Hans Anders en Wehkamp schrappen Meta's camerabril
Hans Anders en Wehkamp stoppen met de verkoop. Anderen filmen met een camerabril is volgens de AP vrijwel altijd verboden. Meta heeft tot 13 oktober.
Lidstaten willen minder cookiebanners, Parlement moet nog
De lidstaten legden hun standpunt over de Digitale Omnibus AVG vast: minder cookietoestemming, een meldpunt per land en ruimte voor AI. Nog geen wet.
Microsoft laat EU-partner meekijken bij toegang tot je data
Een EU-partner kijkt mee als Microsoft-engineers bij je data komen, en de sleutel mag in je eigen HSM. Wat al werkt, wat in test is en wat niet afgedekt is.
Hoe AI-ready is jouw organisatie?
Doe de gratis AI-Readiness Scan: 9 vragen, 2 minuten, direct een persoonlijk advies.